Lección 9 — Cómo Aprende una Inteligencia Artificial: Datos, Patrones y Entrenamiento
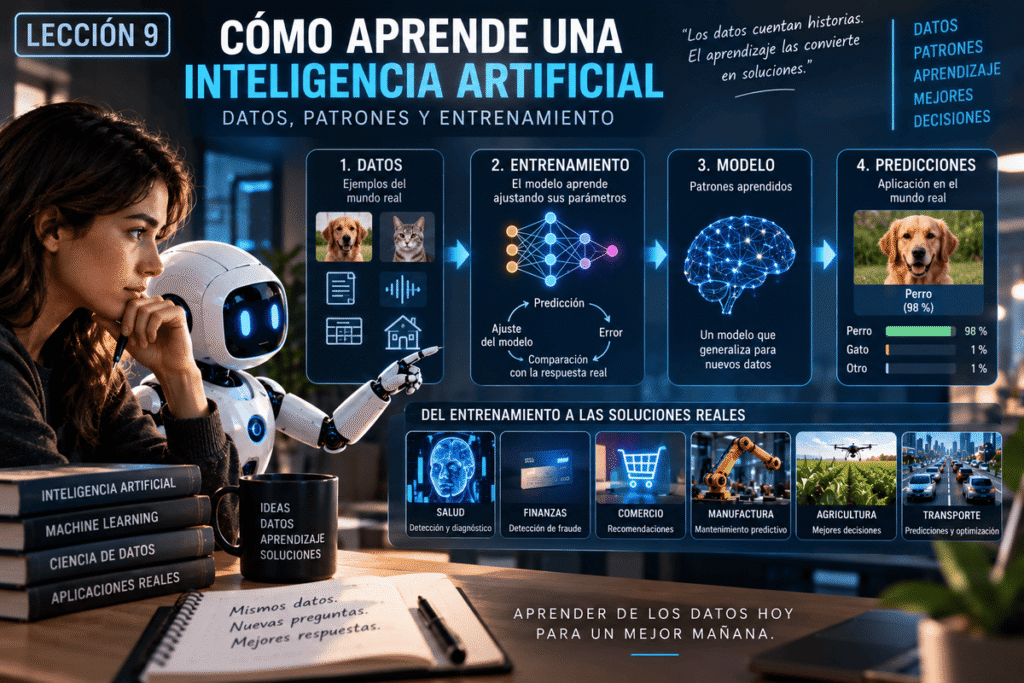
Para comprender cómo aprende la IA, primero necesitamos aclarar qué significa realmente “aprender” cuando hablamos de una máquina. Una inteligencia artificial no estudia, comprende ni adquiere experiencia exactamente como una persona. En machine learning, el aprendizaje ocurre cuando un algoritmo utiliza datos durante un proceso de entrenamiento para ajustar un modelo y encontrar patrones que le permitan producir resultados útiles ante casos nuevos.
Esta idea introduce una diferencia fundamental: aprender no consiste simplemente en memorizar los datos de entrenamiento. El verdadero objetivo es encontrar regularidades que puedan utilizarse más allá de los ejemplos originales.
Podemos representar inicialmente el proceso así:
Datos → Entrenamiento → Patrones aprendidos → Modelo → Casos nuevos
En esta lección abriremos paso a paso ese proceso para entender qué significa que una máquina “aprenda”.
🎯 Qué Aprenderás en Esta Lección
Al finalizar esta lección podrás:
- explicar de manera conceptual cómo aprende una inteligencia artificial;
- comprender qué papel desempeñan los datos durante el aprendizaje;
- distinguir entre datos, patrones y entrenamiento;
- entender que entrenar implica ajustar un modelo;
- diferenciar aprendizaje de simple memorización;
- comprender qué significa generalizar ante casos nuevos;
- reconocer por qué los datos de entrenamiento influyen en lo que aprende un sistema;
- identificar cómo pueden aparecer errores y patrones no deseados;
- comprender por qué necesitamos evaluar el aprendizaje con datos que el modelo no utilizó simplemente para ajustarse;
- analizar un proceso de aprendizaje sin necesidad de conocer todavía sus matemáticas internas.
La capacidad práctica que buscamos desarrollar es:
observar un proceso de machine learning e identificar qué datos utiliza, qué patrones intenta aprender, qué resultado espera producir y cómo comprobaríamos si lo aprendido funciona ante casos nuevos.
🧩 Primero: ¿Qué Significa que una Máquina “Aprenda”?
En la vida cotidiana utilizamos la palabra aprender para describir procesos humanos muy diversos.
Una persona puede aprender:
- mediante explicaciones;
- practicando;
- observando;
- equivocándose;
- relacionando experiencias;
- reflexionando sobre lo ocurrido.
Cuando hablamos de machine learning, utilizamos la misma palabra en un sentido más específico.
Una máquina no necesita “comprender” los ejemplos de la misma manera que nosotros.
En términos generales, durante el entrenamiento ocurre algo como esto:
1. Proporcionamos datos.
2. Un algoritmo procesa esos datos.
3. El sistema ajusta determinados valores internos.
4. Esos ajustes permiten representar patrones encontrados en los datos.
5. El resultado del proceso es un modelo capaz de trabajar con nuevos casos.
Por tanto, cuando decimos:
“La IA aprendió”
una interpretación más precisa sería:
El proceso de entrenamiento ajustó un modelo utilizando datos para que pudiera realizar mejor una determinada tarea.
📊 Los Datos Son la Materia Prima del Aprendizaje
Imaginemos que queremos enseñar a un sistema a distinguir fotografías de manzanas y naranjas.
Necesitamos ejemplos.
Podríamos proporcionar:
- fotografías de manzanas;
- fotografías de naranjas;
- información que indique qué representa cada fotografía.
Esos ejemplos forman parte de los datos de entrenamiento.
El sistema puede encontrar regularidades relacionadas con características presentes en las imágenes.
Pero aquí aparece algo fundamental:
el sistema solamente puede aprender a partir de la información a la que tiene acceso durante el proceso de aprendizaje.
Si nuestros datos contienen problemas, esos problemas pueden afectar al modelo.
Por ejemplo, imaginemos que todas nuestras fotografías de manzanas fueron tomadas:
sobre una mesa blanca
y todas las fotografías de naranjas:
sobre una mesa negra.
¿Qué queremos que aprenda el sistema?
Manzanas vs. naranjas.
¿Qué podría aprender accidentalmente?
Fondo blanco vs. fondo negro.
El modelo podría obtener buenos resultados con los datos disponibles y, sin embargo, haber aprendido el patrón equivocado.
Ésta es una de las razones por las que trabajar con datos exige mucho más que simplemente reunir grandes cantidades de información.
🔍 ¿Qué Es un Patrón?
Un patrón es una regularidad o relación que puede encontrarse en los datos.
Pensemos en algunos ejemplos sencillos.
Una empresa observa que determinadas características de una transacción aparecen con mayor frecuencia en operaciones que requieren revisión.
Un sistema de correo encuentra combinaciones de características asociadas con mensajes no deseados.
Un modelo de vivienda encuentra relaciones entre:
- superficie;
- ubicación;
- antigüedad;
- número de habitaciones;
y los precios históricos.
Un sistema de visión encuentra características visuales relacionadas con diferentes objetos.
Los patrones pueden ser simples o extremadamente complejos.
Y existe una diferencia importante respecto de las reglas escritas manualmente.
En programación tradicional podríamos decir:
Si ocurre A y B, entonces haz C.
En machine learning intentamos que el proceso de entrenamiento encuentre relaciones útiles a partir de los datos.
🧪 Descubre Tú Mismo un Patrón
Observa estos ejemplos:
2 → 4
3 → 6
5 → 10
Ahora intenta responder:
8 → ?
Probablemente respondiste:
16
¿Por qué?
Porque inferiste una posible relación:
salida = entrada × 2
Acabas de hacer algo conceptualmente parecido a buscar un patrón a partir de ejemplos y aplicarlo a un caso que no aparecía entre ellos.
Pero ahora viene la parte interesante.
¿Los tres ejemplos demuestran que ×2 es la única regla posible?
No.
Podrían existir otras reglas matemáticas capaces de coincidir exactamente con esos tres ejemplos y producir otro resultado para 8.
Esto nos enseña algo fundamental:
los datos disponibles pueden ser compatibles con más de un patrón.
Por eso aprender no consiste únicamente en encontrar cualquier regla que funcione con los ejemplos conocidos.
Necesitamos encontrar patrones que también funcionen razonablemente bien ante nuevos casos.
🏋️ ¿Qué Ocurre Durante el Entrenamiento?
En la lección anterior representamos el entrenamiento de forma muy sencilla:
Datos → Entrenamiento → Modelo
Ahora podemos abrir un poco esa caja.
De manera conceptual, el proceso puede incluir:
Datos → Predicción inicial → Comparación con el resultado esperado → Medición del error → Ajuste → Nueva predicción
Este proceso puede repetirse muchas veces.
La idea general es que el sistema va ajustando determinados parámetros del modelo para reducir el error según el criterio utilizado durante el entrenamiento.
Podemos imaginarlo así:
Intentar → Comparar → Ajustar → Volver a intentar
Pero debemos tener cuidado con la analogía.
La máquina no necesariamente está pensando:
“Me equivoqué; ahora entiendo mejor.”
Lo que ocurre es un proceso computacional de optimización mediante el cual determinados valores del modelo son ajustados.
Más adelante estudiaremos con mayor profundidad los modelos y su entrenamiento.
Por ahora necesitamos conservar esta idea:
entrenar significa utilizar datos para ajustar un modelo con el objetivo de mejorar su desempeño en una tarea determinada.
🎯 ¿Cómo Sabe el Sistema que Está Mejorando?
Para ajustar un modelo necesitamos alguna manera de medir qué tan lejos está su resultado de lo que buscamos.
Imaginemos que queremos estimar el precio de una vivienda.
El valor real fue:
$2,000,000
El modelo predice:
$1,600,000
Existe una diferencia entre ambos valores.
El entrenamiento puede utilizar una función matemática para representar ese error y ajustar el modelo buscando reducirlo.
En un problema de clasificación podríamos tener:
Resultado real: naranja
Predicción: manzana
Nuevamente necesitamos una forma de medir el desempeño y utilizar esa información durante el aprendizaje.
Los mecanismos exactos dependen del tipo de modelo y problema.
No necesitamos estudiarlos todavía.
Lo importante es comprender el principio:
para aprender necesitamos alguna forma de evaluar el resultado y orientar los ajustes.
🔄 Aprender Es Ajustar
Esta idea merece quedar especialmente clara.
Un modelo comienza con determinados valores internos.
Durante el entrenamiento:
- recibe información;
- produce resultados;
- esos resultados se evalúan;
- sus parámetros pueden modificarse;
- el proceso continúa.
Después de muchos ajustes, esperamos obtener un modelo que haya capturado patrones útiles.
Así podemos ampliar nuestro esquema:
Datos de entrenamiento
↓
Modelo produce resultados
↓
Medimos el error
↓
Ajustamos parámetros
↓
Repetimos
↓
Modelo entrenado
No todos los sistemas de aprendizaje funcionan exactamente de la misma manera, pero este esquema nos proporciona una base conceptual excelente para comprender muchos modelos modernos.
🧠 El Modelo No Guarda Simplemente una Lista de Respuestas
Supongamos que queremos clasificar imágenes.
Si el sistema únicamente almacenara:
Imagen 1 → gato
Imagen 2 → perro
Imagen 3 → gato
y después solo pudiera reconocer esas mismas imágenes, no tendríamos una solución muy útil.
Queremos algo diferente.
Cuando aparezca:
Imagen 10,437 → nunca vista anteriormente
queremos que el modelo pueda producir una clasificación razonable.
Eso requiere que haya aprendido algo que pueda aplicarse más allá de los ejemplos originales.
Aquí aparece uno de los conceptos más importantes de machine learning:
generalización.
🌱 Generalizar: Utilizar lo Aprendido en Casos Nuevos
La generalización es la capacidad de un modelo para funcionar adecuadamente con datos que no utilizó simplemente para ajustarse durante el entrenamiento.
Pensemos en un estudiante.
Si memoriza:
7 × 8 = 56
puede responder correctamente esa pregunta.
Pero si comprende cómo funciona la multiplicación, puede resolver:
17 × 8 = ?
aunque nunca haya memorizado exactamente esa operación.
La analogía no es perfecta —el aprendizaje humano y el aprendizaje automático son diferentes—, pero nos ayuda a entender la diferencia entre:
memorizar ejemplos
y
capturar una relación que pueda utilizarse en nuevos casos.
En machine learning queremos que el modelo no sea bueno solamente con los datos que ya conoce.
Queremos que pueda trabajar razonablemente bien con situaciones nuevas relacionadas con el problema para el que fue entrenado.
⚠️ Cuando el Modelo Memoriza Demasiado
Imaginemos un estudiante que recibe exactamente las preguntas que aparecerán en el examen.
Memoriza:
- pregunta;
- respuesta;
- pregunta;
- respuesta.
Obtiene 100 %.
Después le hacemos preguntas nuevas sobre los mismos conceptos.
No sabe responder.
Algo conceptualmente parecido puede ocurrir con un modelo.
Puede ajustarse demasiado a los datos utilizados durante el entrenamiento y capturar incluso detalles accidentales o ruido que no resultan útiles para nuevos casos.
Este problema se conoce como sobreajuste (overfitting).
De forma simplificada:
Excelente desempeño en datos conocidos + mal desempeño en casos nuevos = posible sobreajuste
No necesitamos aprender todavía las técnicas para combatirlo.
Pero desde ahora debemos comprender una consecuencia práctica:
evaluar un modelo únicamente con los mismos datos utilizados para ajustarlo puede producir una impresión engañosa de su capacidad real.
🧪 Datos de Entrenamiento y Datos de Prueba
¿Cómo podemos saber si el modelo aprendió patrones útiles en lugar de simplemente adaptarse demasiado a los ejemplos conocidos?
Una estrategia fundamental consiste en reservar datos que no se utilicen para ajustar el modelo.
Podemos pensar inicialmente en dos grupos:
🏋️ Datos de entrenamiento
Se utilizan para que el modelo aprenda y ajuste sus parámetros.
🧪 Datos de prueba
Se utilizan posteriormente para evaluar cómo funciona ante ejemplos que no utilizó para aprender.
Simplificando:
Datos disponibles
↙ ↘
Entrenamiento Prueba
↓ ↓
Aprender Evaluar
En proyectos reales pueden existir divisiones adicionales, como conjuntos de validación, y procedimientos de evaluación más sofisticados.
Los estudiaremos cuando corresponda.
Por ahora conserva el principio:
no debemos evaluar la capacidad de generalización utilizando únicamente los ejemplos con los que el modelo fue ajustado.
🗂️ Los Datos de Entrenamiento Determinan Qué Puede Aprender
Regresemos al ejemplo de manzanas y naranjas.
Imaginemos que tenemos 10,000 fotografías.
Eso suena impresionante.
Pero resulta que:
- todas fueron tomadas durante el día;
- todas tienen fondo blanco;
- todas muestran la fruta completa;
- ninguna contiene varias frutas;
- ninguna presenta iluminación difícil.
Después utilizamos el modelo en una tienda real donde aparecen:
- diferentes fondos;
- sombras;
- frutas parcialmente ocultas;
- cajas;
- bolsas;
- diferentes cámaras.
El problema no necesariamente está en que el modelo sea “malo”.
Puede existir una diferencia importante entre:
los datos con los que aprendió
y
el mundo donde queremos utilizarlo.
Por eso una pregunta profesional fundamental es:
¿Los datos de entrenamiento representan suficientemente bien las situaciones reales que encontrará el sistema?
⚖️ Cantidad de Datos No Es Igual a Calidad de Datos
Supongamos que tenemos dos conjuntos.
Conjunto A
10 millones de ejemplos, pero:
- muchos están duplicados;
- contienen errores;
- representan muy pocos tipos de casos;
- incluyen información irrelevante.
Conjunto B
500,000 ejemplos, pero:
- fueron cuidadosamente seleccionados;
- representan una variedad adecuada;
- tienen buena calidad;
- contienen información relevante para la tarea.
No podemos concluir automáticamente que A sea mejor simplemente porque contiene más datos.
La utilidad depende de factores como:
- calidad;
- diversidad;
- representatividad;
- relevancia;
- cobertura;
- precisión de las etiquetas, cuando existan.
Por eso:
más datos pueden ayudar, pero “más” no sustituye automáticamente a “mejores”.
🚨 Un Modelo También Puede Aprender Patrones que No Queríamos
Ésta es una consecuencia especialmente importante.
Imaginemos que queremos construir un sistema para identificar determinado tipo de producto defectuoso.
Todas las fotografías de productos defectuosos fueron tomadas con una cámara diferente a la utilizada para fotografiar productos correctos.
El modelo podría aprender:
tipo de cámara → categoría
en lugar de:
características del defecto → categoría
Obtendríamos aparentemente buenos resultados durante determinadas pruebas, pero habríamos construido un sistema frágil.
Esto nos enseña que no basta con preguntar:
“¿Aprendió?”
Necesitamos preguntar:
“¿Qué aprendió realmente?”
y:
“¿Funcionará ese patrón cuando cambien las condiciones?”
💻 Experimenta primero; amplía tus recursos cuando el proyecto lo necesite
Aprender machine learning no comienza comprando una computadora especializada. Muchos ejercicios permiten trabajar con conjuntos de datos pequeños y herramientas disponibles en línea.
Cuando avances hacia proyectos locales con mayores volúmenes de datos o modelos más exigentes, podrás evaluar qué capacidad de procesamiento, memoria y almacenamiento necesita realmente tu trabajo.
Explora opciones para tus proyectos tecnológicos →
🌍 Aprender del Pasado para Trabajar con el Futuro
Gran parte de machine learning depende de una suposición práctica:
los patrones aprendidos de datos anteriores serán suficientemente útiles para los casos futuros donde utilizaremos el modelo.
Pero el mundo puede cambiar.
Por ejemplo:
- cambian los hábitos de los clientes;
- aparecen nuevos tipos de fraude;
- cambia un proceso industrial;
- se modifica un mercado;
- aparecen nuevos productos;
- cambia el lenguaje utilizado por las personas.
Un modelo que funcionaba bien puede perder efectividad si las condiciones cambian significativamente.
Esto significa que el aprendizaje no termina necesariamente cuando finalizamos el entrenamiento inicial.
En aplicaciones reales también debemos:
- observar el desempeño;
- detectar cambios;
- reevaluar resultados;
- actualizar datos;
- volver a entrenar cuando corresponda.
La IA no es necesariamente un objeto que entrenamos una vez y funciona perfectamente para siempre.
🔁 Entrenamiento No Significa Aprendizaje Continuo
Existe una confusión frecuente:
“Si utilizo una IA, aprende automáticamente de todo lo que hago.”
No necesariamente.
Un modelo puede haber sido entrenado previamente y después utilizarse muchas veces sin modificar sus parámetros en cada interacción.
Recordemos:
Entrenamiento
Datos → Ajuste del modelo
Inferencia
Nuevo dato → Modelo ya entrenado → Resultado
Un sistema puede recopilar posteriormente información para mejorar futuras versiones, si su diseño y políticas lo contemplan, pero eso no significa que cada interacción individual modifique inmediatamente el modelo que estamos utilizando.
Esta distinción evita interpretar incorrectamente cómo funcionan muchas aplicaciones de IA.
🔍 Del Dato al Resultado: Sigamos un Caso Completo
Supongamos que una empresa quiere clasificar mensajes de clientes.
1. Definimos el problema
Queremos identificar:
- ventas;
- soporte;
- facturación.
2. Reunimos ejemplos
Disponemos de mensajes anteriores.
3. Preparamos los datos
Necesitamos revisar su calidad y las categorías disponibles.
4. Entrenamos
El algoritmo utiliza los ejemplos para ajustar un modelo.
5. El modelo aprende patrones
Encuentra relaciones entre características de los mensajes y las categorías.
6. Probamos con casos no utilizados para el ajuste
Evaluamos cómo responde ante mensajes diferentes.
7. Analizamos errores
¿Confunde facturación con soporte?
¿En qué casos?
8. Utilizamos el modelo
Un mensaje nuevo llega:
“Me cobraron dos veces el pedido.”
El modelo produce:
Facturación
9. El sistema actúa
Una automatización puede dirigirlo al área correspondiente.
Observa el proceso completo:
Problema → Datos → Entrenamiento → Modelo → Evaluación → Inferencia → Acción
Machine learning es solamente una parte de la solución completa.
🧪 Actividad Práctica: Aprende Como Nuestro Modelo Imaginario
Vamos a simular un pequeño proceso de aprendizaje.
Tenemos estos datos de una tienda:
| Visitas recientes | Compró |
|---|---|
| 1 | No |
| 2 | No |
| 7 | Sí |
| 8 | Sí |
| 9 | Sí |
Ahora aparece un cliente con:
8 visitas recientes
¿Qué predecirías?
Probablemente:
Sí
Pero ahora aparece:
4 visitas recientes
¿Qué haces?
Los ejemplos ya no proporcionan una respuesta tan evidente.
Y aparecen preguntas:
- ¿cuántas visitas son suficientes?;
- ¿es realmente el número de visitas la causa?;
- ¿faltan otras variables?;
- ¿tenemos suficientes ejemplos?;
- ¿los datos representan a todos los clientes?;
- ¿qué ocurre con alguien que visita mucho y nunca compra?
La finalidad del ejercicio no es construir un modelo real.
Es experimentar una dificultad fundamental:
los datos contienen información, pero transformar esa información en un patrón generalizable requiere decisiones y evaluación.
🕵️ Segundo Experimento: Encuentra el Patrón Equivocado
Supongamos que tenemos:
| Producto | Color del fondo | Estado |
|---|---|---|
| A | Blanco | Correcto |
| B | Blanco | Correcto |
| C | Blanco | Correcto |
| D | Negro | Defectuoso |
| E | Negro | Defectuoso |
| F | Negro | Defectuoso |
Nuestro objetivo es detectar defectos.
Pero observa los datos.
Existe una relación perfecta:
Blanco → Correcto
Negro → Defectuoso
Un modelo podría utilizar el fondo para realizar predicciones aparentemente perfectas.
Ahora llevamos el sistema a producción.
Todos los productos aparecen sobre fondo gris.
¿Qué podría ocurrir?
Este pequeño experimento demuestra una idea enorme:
un modelo puede encontrar una correlación útil para los datos de entrenamiento que no representa la relación que realmente nos interesa.
Por eso necesitamos comprender los datos, no solamente alimentar un algoritmo con ellos.
🧭 Cómo Analizar un Proceso de Aprendizaje
Cuando encuentres un sistema de machine learning, intenta responder:
- ¿Qué problema intenta resolver?
- ¿Qué resultado debe producir?
- ¿Qué datos utiliza para aprender?
- ¿De dónde provienen esos datos?
- ¿Qué representan?
- ¿Qué casos podrían faltar?
- ¿Qué patrones queremos que aprenda?
- ¿Qué patrones accidentales podría aprender?
- ¿Cómo sabemos si funciona con casos nuevos?
- ¿Qué tipos de error comete?
- ¿Qué ocurre cuando cambian las condiciones?
- ¿Cómo se utilizará finalmente el resultado?
Estas preguntas son útiles incluso cuando no conocemos el algoritmo específico.
Eso es importante porque podemos desarrollar criterio sobre machine learning antes de dominar sus matemáticas internas.
🛠️ Mini Práctica: Diseña los Datos Antes del Modelo
Elige uno de estos problemas:
- detectar correo no deseado;
- estimar demanda de productos;
- clasificar fotografías;
- identificar solicitudes urgentes;
- recomendar contenido.
Ahora responde:
Problema:
¿Qué queremos resolver exactamente?
Resultado:
¿Qué debe producir el modelo?
Datos:
¿Qué ejemplos necesitaríamos?
Variedad:
¿Qué situaciones diferentes deberían aparecer?
Ausencias:
¿Qué casos podrían faltar?
Patrones incorrectos:
¿Qué característica accidental podría engañar al modelo?
Prueba:
¿Qué datos reservaríamos para comprobar si generaliza?
Error:
¿Qué equivocaciones serían especialmente importantes?
Este ejercicio invierte una tendencia frecuente.
En lugar de empezar diciendo:
“Quiero entrenar una IA.”
comenzamos preguntando:
“¿Qué tendría que aprender y qué evidencia necesitaríamos para saber que realmente lo aprendió?”
📝 Comprueba lo que Aprendiste
- ¿Qué significa “aprender” en machine learning?
- ¿Qué papel desempeñan los datos de entrenamiento?
- ¿Qué es un patrón?
- ¿Por qué varios patrones pueden ajustarse a los mismos ejemplos?
- ¿Qué significa entrenar un modelo?
- ¿Por qué necesitamos medir el error durante determinados procesos de entrenamiento?
- ¿Qué significa generalización?
- ¿Por qué memorizar los datos de entrenamiento no es suficiente?
- ¿Qué es el sobreajuste?
- ¿Por qué no deberíamos evaluar un modelo únicamente con los mismos datos utilizados para ajustarlo?
- ¿Por qué 10 millones de ejemplos no son automáticamente mejores que 500,000?
- ¿Cómo puede un modelo aprender un patrón accidental?
- ¿Qué puede ocurrir cuando el mundo real cambia respecto de los datos históricos?
- ¿Cuál es la diferencia entre entrenamiento e inferencia?
- ¿Utilizar una IA significa necesariamente que está aprendiendo de nosotros en ese momento?
Si puedes explicar la relación:
Datos → Patrones → Entrenamiento → Generalización → Evaluación
ya estás comprendiendo mucho mejor qué significa realmente decir que una IA aprende.
📌 Ideas Clave de la Lección
- En machine learning, aprender significa ajustar un modelo utilizando datos.
- Los datos contienen ejemplos a partir de los cuales pueden encontrarse patrones.
- Un patrón es una regularidad o relación presente en los datos.
- Los mismos ejemplos pueden ser compatibles con diferentes patrones.
- El entrenamiento busca ajustar el modelo para realizar mejor una tarea.
- Aprender no significa simplemente memorizar los ejemplos.
- La generalización permite utilizar lo aprendido ante casos nuevos.
- Un modelo puede sobreajustarse a los datos de entrenamiento.
- Necesitamos evaluar con información que no haya servido simplemente para ajustar el modelo.
- Cantidad de datos y calidad de datos no son equivalentes.
- Un modelo puede aprender correlaciones accidentales o patrones no deseados.
- Los datos deben representar razonablemente el contexto donde utilizaremos el sistema.
- Si las condiciones cambian, el desempeño también puede cambiar.
- Entrenamiento e inferencia son procesos diferentes.
- Un modelo no necesariamente aprende de cada interacción durante su utilización.
🎯 Lo Que Ahora Eres Capaz de Hacer
Antes de esta lección sabías que machine learning permite aprender patrones a partir de datos.
Ahora puedes mirar dentro de ese proceso.
Puedes preguntar:
¿Con qué datos está aprendiendo?
¿Qué patrón queremos que encuentre?
¿Qué patrón equivocado podría encontrar?
¿Está aprendiendo o simplemente memorizando?
¿Funciona con casos que no utilizó para ajustarse?
¿Qué ocurre si cambian las condiciones?
Eso representa un avance importante.
Ya no interpretamos:
“La IA aprende.”
como una explicación suficiente.
Ahora sabemos que necesitamos entender:
qué aprende, a partir de qué datos, mediante qué proceso general y cómo comprobamos que lo aprendido resulta útil.
🧭 Continúa Tu Ruta de Aprendizaje
Hemos abierto la caja que en la lección anterior representábamos simplemente como:
Datos → Aprendizaje → Modelo
Ahora comprendemos mejor el papel de los datos, los patrones, el entrenamiento, los errores y la generalización.
Pero todavía nos falta estudiar con mayor precisión el resultado central de ese proceso:
el modelo de inteligencia artificial.