Lección 12 — Clasificación, Regresión y Clustering: Tres Formas de Aprender con Datos
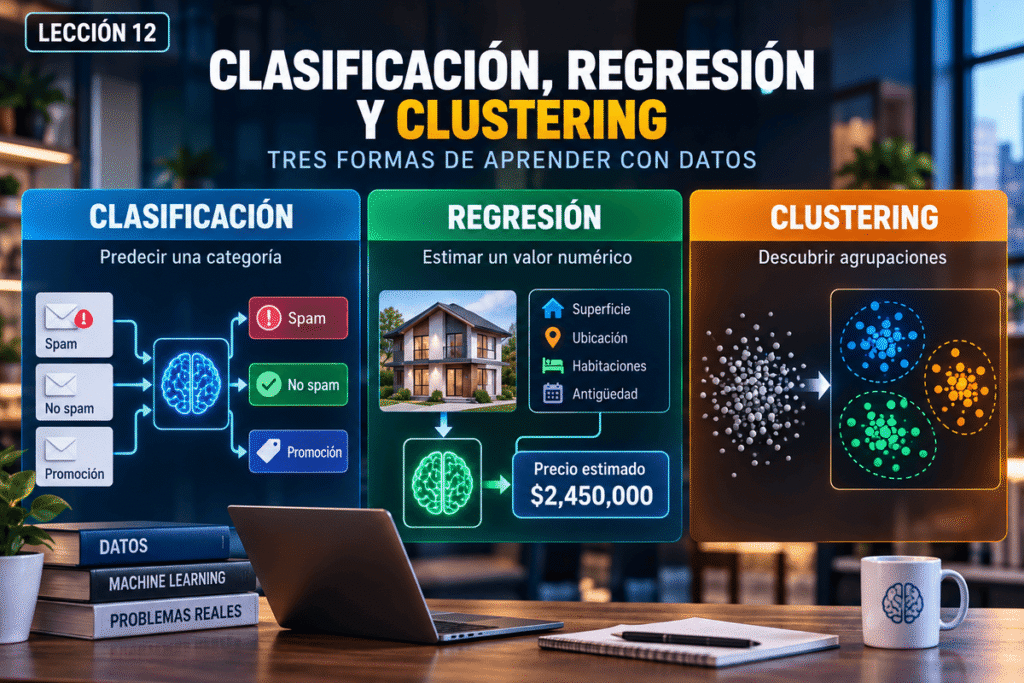
En machine learning, la clasificación, la regresión y el clustering permiten resolver problemas diferentes según el tipo de resultado que necesitamos obtener. Podemos querer asignar una categoría, estimar un valor numérico o descubrir agrupaciones dentro de los datos. Reconocer estas diferencias es más importante que memorizar algoritmos, porque primero debemos identificar correctamente qué problema intentamos resolver.
Podemos comenzar con un mapa muy sencillo:
Clasificación → predecir una categoría
Regresión → estimar un valor numérico
Clustering → descubrir agrupaciones
Las tres trabajan con datos, pero no responden la misma pregunta.
🎯 Qué Aprenderás en Esta Lección
Al finalizar esta lección podrás:
- explicar qué son clasificación, regresión y clustering;
- reconocer qué tipo de resultado produce cada tarea;
- relacionar clasificación y regresión con aprendizaje supervisado;
- relacionar clustering con aprendizaje no supervisado;
- distinguir entre predecir una categoría y estimar un valor numérico;
- diferenciar una categoría previamente definida de un grupo descubierto a partir de los datos;
- formular un mismo problema de diferentes maneras según el resultado que necesitamos;
- detectar problemas mal planteados antes de seleccionar un modelo;
- comprender que identificar correctamente la tarea debe ocurrir antes de escoger un algoritmo.
La capacidad práctica que buscamos desarrollar es:
analizar un problema real y reconocer si necesitamos predecir una categoría, estimar un valor o descubrir agrupaciones en los datos.
🧭 Del Tipo de Aprendizaje al Tipo de Tarea
En la lección anterior distinguimos:
Aprendizaje supervisado → conocemos el resultado objetivo de los ejemplos utilizados para aprender.
Aprendizaje no supervisado → buscamos estructura sin proporcionar de la misma manera una respuesta objetivo conocida para cada ejemplo.
Ahora avanzaremos un nivel.
Dentro del aprendizaje supervisado encontramos dos tareas fundamentales:
- clasificación;
- regresión.
Y dentro del aprendizaje no supervisado encontramos, entre otras posibilidades:
- clustering.
Nuestro mapa inicial queda así:
Machine Learning
↳ Supervisado
- Clasificación
- Regresión
↳ No supervisado
- Clustering
Esto es una simplificación útil para comenzar. Existen más tipos de tareas y otros paradigmas de aprendizaje, pero estos tres conceptos nos permiten reconocer una gran cantidad de problemas prácticos.
🏷️ ¿Qué Es la Clasificación en Machine Learning?
La clasificación es una tarea en la que queremos que un modelo determine a qué categoría pertenece una entrada.
Supongamos que tenemos mensajes históricos clasificados como:
- ventas;
- soporte;
- facturación.
Entrenamos utilizando esos ejemplos.
Después llega:
“Me hicieron dos cargos por la misma compra.”
Queremos obtener:
Facturación
La estructura del problema es:
Entrada → Modelo → Categoría
Otros ejemplos podrían ser:
Correo electrónico → Spam / No spam
Fotografía → Perro / Gato
Producto → Correcto / Defectuoso
Transacción → Requiere revisión / No requiere revisión
El elemento característico es que el resultado pertenece a una categoría o clase previamente definida.
🔢 Clasificar No Significa Solamente Trabajar con Palabras
Supongamos que nuestro modelo produce:
Clase 0
Clase 1
Aunque el resultado esté representado mediante números, podría continuar siendo un problema de clasificación.
¿Por qué?
Porque esos números pueden representar categorías, no cantidades.
Por ejemplo:
0 = No spam
1 = Spam
Aquí el número 1 no significa:
“Hay una unidad de spam.”
Es simplemente una representación de una clase.
Por eso no debemos decidir si algo es clasificación o regresión solamente observando si la salida utiliza números.
Debemos preguntar:
¿Ese resultado representa una categoría o una cantidad?
⚖️ Clasificación Binaria y Multiclase
Una clasificación puede tener solamente dos posibilidades.
Por ejemplo:
Aprobado / Rechazado
Defectuoso / Correcto
Spam / No spam
Esto suele denominarse clasificación binaria.
Pero también podemos tener varias categorías:
- ventas;
- soporte;
- facturación;
- reclamaciones.
O:
- perro;
- gato;
- caballo;
- ave.
Esto puede plantearse como clasificación multiclase.
No necesitamos profundizar todavía en sus algoritmos.
Lo importante es reconocer que:
clasificar significa seleccionar entre clases definidas para el problema.
📈 ¿Qué Es la Regresión en Machine Learning?
En regresión, el objetivo cambia.
No queremos seleccionar una categoría.
Queremos estimar un valor numérico.
Imaginemos información histórica de viviendas.
Tenemos:
- superficie;
- ubicación;
- antigüedad;
- número de habitaciones;
- precio de venta.
Queremos estimar el precio de una vivienda nueva.
La estructura es:
Características → Modelo → Valor estimado
Por ejemplo:
Vivienda → $2,450,000
No estamos diciendo:
“Esta vivienda pertenece a la categoría $2,450,000.”
Estamos estimando una cantidad.
Otros ejemplos podrían ser:
Datos históricos → demanda estimada
Características de un vehículo → precio estimado
Información de consumo → energía esperada
Variables de producción → tiempo estimado
El elemento central es:
Regresión → predecir o estimar un valor numérico.
🏠 Clasificación y Regresión Pueden Utilizar Datos Parecidos
Imagina que tenemos exactamente la misma información de viviendas:
- superficie;
- ubicación;
- habitaciones;
- antigüedad.
Podemos plantear dos problemas distintos.
Problema A
Queremos estimar:
Precio: $2,800,000
Esto apunta a regresión.
Problema B
Queremos determinar:
Rango económico / medio / alto
Esto apunta a clasificación.
Los datos de entrada podrían ser muy similares.
Lo que cambió fue el resultado que decidimos producir.
Esta idea es fundamental:
El tipo de tarea no depende únicamente de los datos disponibles. También depende de la pregunta que queremos responder.
🧠 Categoría vs. Cantidad
Una forma práctica de distinguir clasificación y regresión es preguntar:
¿Quiero saber cuál?
Probablemente estamos ante una categoría.
Ejemplo:
¿Cuál departamento debe recibir este mensaje?
→ Clasificación.
¿Quiero saber cuánto?
Probablemente necesitamos estimar una cantidad.
Ejemplo:
¿Cuánto podría costar esta vivienda?
→ Regresión.
No es una regla perfecta para todos los problemas, pero resulta muy útil como primera aproximación:
¿Cuál? → Clasificación
¿Cuánto? → Regresión
⚠️ Un Número No Convierte Automáticamente el Problema en Regresión
Supongamos que queremos predecir una calificación:
1 estrella
2 estrellas
3 estrellas
4 estrellas
5 estrellas
Tenemos números.
¿Es automáticamente regresión?
No necesariamente.
Podríamos tratar esas posibilidades como categorías ordenadas dependiendo de cómo formulemos el problema.
Ahora imagina:
Temperatura esperada: 27.4 °C
Aquí sí estamos estimando una cantidad numérica.
Por eso debemos evitar la regla superficial:
“Si hay números, es regresión.”
La pregunta correcta es:
¿Qué representa el resultado y cómo necesitamos utilizarlo?
🧩 ¿Qué Es Clustering en Machine Learning?
Ahora cambiamos de escenario.
Tenemos información de miles de clientes:
- frecuencia de compra;
- gasto promedio;
- categorías adquiridas;
- número de pedidos;
- tiempo desde la última compra.
Pero no tenemos grupos previamente definidos.
Queremos descubrir si existen clientes con comportamientos similares.
Aquí aparece el clustering, también conocido como agrupamiento.
Su objetivo general es encontrar agrupaciones dentro de los datos utilizando algún criterio de similitud.
Podemos representarlo así:
Datos sin grupos objetivo previamente definidos → Clustering → Grupos descubiertos
A diferencia de la clasificación, no comenzamos diciendo:
“Éstas son las categorías correctas que debes aprender.”
Queremos descubrir estructura.
👥 Clasificación y Clustering Parecen Parecidos, Pero No Son lo Mismo
Ésta es una confusión especialmente frecuente.
Ambos pueden terminar mostrando grupos.
Pero el origen de esos grupos es diferente.
Clasificación
Las categorías ya forman parte del problema.
Por ejemplo:
- cliente nuevo;
- cliente recurrente;
- cliente inactivo.
Tenemos ejemplos históricos identificados y queremos clasificar nuevos casos.
Clustering
Los grupos no se proporcionan previamente de esa manera como respuestas objetivo.
Queremos explorar:
¿Qué agrupaciones aparecen según las características de los datos?
Por ejemplo, el análisis podría encontrar tres grupos con diferentes comportamientos de compra.
Después nosotros tendremos que estudiar qué significan.
Podemos resumir:
Clasificación → asignar una categoría conocida.
Clustering → descubrir agrupaciones.
🔎 Un Cluster No Es Automáticamente una Categoría Útil
Supongamos que un método de clustering encuentra:
Cluster 1
Cluster 2
Cluster 3
Eso todavía no nos dice qué significan.
Debemos analizar características como:
- frecuencia de compra;
- gasto;
- productos;
- recurrencia;
- comportamiento.
Tal vez descubramos:
Cluster 1 → compradores frecuentes de bajo importe
Cluster 2 → compradores ocasionales de alto importe
Cluster 3 → clientes con poca actividad reciente
Pero esas interpretaciones son resultado de nuestro análisis posterior.
El algoritmo encontró agrupaciones según determinados criterios.
No encontró automáticamente conceptos empresariales universales.
⚖️ Clasificación, Regresión y Clustering Frente a Frente
| Tarea | ¿Qué buscamos? | Resultado típico | Aprendizaje relacionado |
|---|---|---|---|
| Clasificación | Predecir una categoría | Spam / No spam | Supervisado |
| Regresión | Estimar un valor | $2,450,000 | Supervisado |
| Clustering | Descubrir agrupaciones | Cluster 1, 2, 3 | No supervisado |
Podemos reducirlo todavía más:
Clasificación → ¿Cuál?
Regresión → ¿Cuánto?
Clustering → ¿Qué grupos existen?
Pero recuerda: estas preguntas son herramientas conceptuales, no sustitutos del análisis del problema.
🏭 Un Solo Problema Real Puede Contener las Tres Tareas
Imaginemos una fábrica.
Tenemos información de:
- máquinas;
- sensores;
- mantenimiento;
- producción;
- fallas.
Podríamos plantear tres preguntas diferentes.
Clasificación
¿Esta máquina presenta una condición normal o una posible anomalía definida?
Resultado:
Normal / Requiere revisión
Regresión
¿Cuántas horas estimamos antes de alcanzar determinada condición?
Resultado:
127 horas
Clustering
¿Existen grupos de máquinas con patrones de comportamiento similares?
Resultado:
Cluster A / B / C
La misma organización, e incluso parte de los mismos datos, puede dar lugar a problemas diferentes.
Por eso debemos comenzar por:
la pregunta
y no por:
el algoritmo.
🩺 Otro Ejemplo: Datos Relacionados con Salud
Supongamos que trabajamos con un conjunto de datos clínicos debidamente gestionado.
Podríamos plantear:
Clasificación
Estimar a qué categoría previamente definida corresponde determinado caso.
Regresión
Estimar un valor numérico relevante.
Clustering
Explorar si aparecen grupos con características similares que merezcan análisis posterior.
Pero aquí debemos introducir una precaución fundamental:
el resultado de un modelo no equivale automáticamente a una decisión médica.
En contextos de alto impacto necesitamos considerar:
- validación rigurosa;
- calidad de datos;
- seguridad;
- privacidad;
- supervisión profesional;
- consecuencias de los errores.
La estructura matemática del problema puede parecer similar a otros sectores, pero el riesgo de utilizar incorrectamente el resultado puede ser muy diferente.
🎯 Primero Define Qué Quieres Predecir o Descubrir
Imagina que alguien dice:
“Quiero hacer machine learning con los datos de mis clientes.”
Todavía no tenemos un problema suficientemente definido.
Necesitamos preguntar:
¿Qué quieres saber?
Podría responder:
“Quiero predecir si un cliente renovará.”
Eso apunta a clasificación, si tenemos ejemplos apropiados con el resultado conocido.
O:
“Quiero estimar cuánto comprará el próximo mes.”
Eso apunta a regresión, si disponemos de los datos adecuados.
O:
“Quiero descubrir diferentes patrones de comportamiento entre mis clientes.”
Eso podría apuntar a clustering.
Una misma frase inicial:
“Quiero usar IA con mis clientes”
puede esconder problemas completamente diferentes.
🚫 No Empieces Preguntando Qué Algoritmo Utilizar
Es común escuchar preguntas como:
“¿Debo utilizar una red neuronal?”
“¿Debo utilizar K-means?”
“¿Debo utilizar regresión lineal?”
Pero esas preguntas llegan demasiado pronto.
Antes necesitamos saber:
1. ¿Qué problema queremos resolver?
2. ¿Qué resultado necesitamos?
3. ¿Qué datos tenemos?
4. ¿Conocemos el resultado objetivo en nuestros ejemplos?
5. ¿Queremos predecir o descubrir estructura?
Después podemos estudiar qué algoritmos podrían resultar apropiados.
Nuestro orden será:
Problema → Tipo de tarea → Datos → Evaluación → Modelo/Algoritmo
No:
Algoritmo → buscar un problema donde meterlo.
💻 Primero define el problema; después dimensiona los recursos
Clasificar, estimar valores o analizar grandes conjuntos de datos puede requerir recursos tecnológicos muy diferentes. No necesitas comenzar con el equipo más potente: necesitas saber qué problema vas a resolver y cómo vas a trabajarlo.
Cuando tus proyectos demanden mayor capacidad de procesamiento, memoria o almacenamiento, podrás elegir el equipo según una necesidad concreta y no solamente por especificaciones.
Explora opciones para tus proyectos tecnológicos →
🔄 El Mismo Objetivo Puede Formularse de Diferentes Maneras
Supongamos que una empresa quiere comprender el valor futuro de sus ventas.
Podría plantear:
Regresión
¿Cuánto venderemos el próximo mes?
Resultado:
$850,000
Pero también podría reformularlo como:
Clasificación
¿Las ventas del próximo mes serán bajas, medias o altas?
Resultado:
Altas
Las dos formulaciones están relacionadas, pero no producen exactamente la misma información.
La primera proporciona una cantidad estimada.
La segunda proporciona una categoría.
Entonces aparece una pregunta importante:
¿Qué resultado será realmente más útil para tomar la decisión posterior?
Elegir entre clasificación y regresión no debe depender solamente de cuál sea técnicamente posible.
Debe depender también de cómo utilizaremos el resultado.
🧪 Experimento: Cambia la Pregunta y Cambia la Tarea
Tenemos información de vehículos:
- marca;
- modelo;
- antigüedad;
- kilometraje;
- mantenimiento;
- características.
Ahora formula tres preguntas.
Pregunta A
¿Cuál será aproximadamente su precio de reventa?
Resultado esperado:
$185,000
→ Regresión.
Pregunta B
¿Pertenece al rango económico, medio o alto?
Resultado esperado:
Medio
→ Clasificación.
Pregunta C
¿Qué grupos de vehículos con características similares aparecen en nuestros datos?
No definimos previamente esos grupos.
→ Clustering.
Los datos pueden ser casi idénticos.
Lo que transformó el problema fue:
la pregunta que queremos responder.
📏 ¿Cómo Evaluamos Cada Tipo de Tarea?
No podemos utilizar exactamente la misma idea de evaluación para todo.
Clasificación
Podemos comparar:
Categoría predicha ↔ Categoría real
Pero incluso aquí no basta siempre con preguntar qué porcentaje acertó.
Dependiendo del problema, ciertos errores pueden ser mucho más importantes que otros.
Regresión
Podemos comparar:
Valor estimado ↔ Valor real
y medir qué tan grandes son los errores.
Clustering
No siempre disponemos de una categoría “correcta” previamente conocida.
Podemos necesitar estudiar:
- qué tan coherentes son los grupos;
- qué tan separados aparecen;
- qué tan estables son;
- si son interpretables;
- si aportan utilidad al objetivo real.
La evaluación depende del problema.
Por eso:
identificar la tarea también ayuda a decidir cómo debemos medir el éxito.
⚠️ No Todos los Errores Cuestan lo Mismo
Supongamos un sistema de clasificación industrial.
Puede cometer:
Error A: marcar como defectuosa una pieza correcta.
Error B: marcar como correcta una pieza defectuosa.
Ambos son errores.
Pero quizá sus consecuencias sean muy diferentes.
Ahora pensemos en regresión.
Una estimación puede equivocarse:
$100
o:
$100,000
Ambas son técnicamente errores, pero no tienen la misma magnitud.
Esto introduce un principio que utilizaremos muchas veces:
No debemos evaluar un modelo solamente con una métrica aislada; debemos comprender qué significan sus errores en el problema real.
🧠 ¿Qué Ocurre si Formulamos Mal el Problema?
Imaginemos que necesitamos conocer el consumo eléctrico esperado de una instalación.
Pero decidimos convertirlo en:
Bajo / Medio / Alto
Podemos hacerlo.
Sin embargo, quizá la operación necesite saber:
427.6 kWh
para planificar recursos.
En ese caso, convertir una cantidad continua en tres categorías podría eliminar información importante.
También puede ocurrir lo contrario.
Quizá no necesitamos una estimación extremadamente precisa.
Tal vez la decisión real sea únicamente:
Aceptar / Revisar
Entonces construir una predicción numérica compleja podría añadir trabajo sin mejorar la decisión.
La pregunta correcta no es:
“¿Qué modelo puedo construir?”
sino:
“¿Qué resultado necesita realmente el proceso?”
🕵️ Actividad Práctica: Identifica la Tarea
Clasifica cada problema como:
Clasificación, Regresión o Clustering.
Caso 1
Una empresa quiere predecir si una factura será pagada:
A tiempo / Con retraso
Caso 2
Una empresa quiere estimar cuántos días tardará en pagarse una factura.
Caso 3
Una tienda quiere descubrir grupos de productos con patrones de venta similares sin definir previamente esos grupos.
Caso 4
Un sistema analiza fotografías de frutas y determina:
Manzana / Naranja / Plátano
Caso 5
Una empresa quiere estimar el consumo energético del próximo día.
Caso 6
Una plataforma quiere explorar si existen diferentes grupos de usuarios según sus patrones de utilización.
Intenta responder antes de continuar.
✅ Analicemos las Respuestas
Caso 1 — Clasificación
El resultado es una categoría:
A tiempo / Con retraso
Caso 2 — Regresión
Queremos estimar una cantidad:
número de días.
Caso 3 — Clustering
Queremos descubrir grupos sin haberlos proporcionado previamente como categorías objetivo.
Caso 4 — Clasificación
El resultado pertenece a una de varias categorías conocidas.
Caso 5 — Regresión
Queremos estimar un valor numérico de consumo.
Caso 6 — Clustering
Queremos explorar agrupaciones según similitudes de comportamiento.
Observa que algunos casos pueden utilizar datos similares y, aun así, representar tareas diferentes.
🧩 Caso Más Difícil: ¿Clasificación o Regresión?
Una empresa quiere anticipar el riesgo de que un cliente deje de pagar.
Alguien propone que el modelo produzca:
Alto / Medio / Bajo
Eso apunta a clasificación.
Otra persona propone:
Probabilidad estimada: 0.82
¿Eso significa automáticamente que ahora tenemos regresión?
No necesariamente.
Muchos modelos de clasificación pueden producir puntuaciones o probabilidades asociadas con las clases.
Por tanto, no debemos identificar el tipo de tarea observando únicamente el formato visible de una salida.
Necesitamos entender:
qué está modelando el sistema y cuál es el objetivo del aprendizaje.
Éste es un ejemplo de por qué las reglas rápidas ayudan a comenzar, pero no sustituyen el razonamiento.
🛠️ Mini Práctica: Convierte un Problema en Tres
Elige un contexto:
- ventas;
- manufactura;
- educación;
- agricultura;
- logística;
- energía.
Ahora formula tres problemas.
Clasificación
¿Qué categoría quieres predecir?
Entrada → ________
Regresión
¿Qué cantidad quieres estimar?
Entrada → ________
Clustering
¿Qué agrupaciones quieres explorar sin definirlas previamente?
Datos → ________
Después responde:
¿Cuál de los tres resolvería una necesidad real?
¿Qué datos necesitarías?
¿Qué resultado utilizaría una persona o sistema?
¿Qué ocurriría después de obtener ese resultado?
La finalidad no es inventar tres usos de IA porque sí.
Es aprender que formular correctamente el problema determina qué tipo de aprendizaje necesitamos.
🧭 Método Práctico para Reconocer la Tarea
Cuando tengas un problema, sigue esta secuencia.
1. Define la decisión o necesidad
¿Qué queremos conseguir?
2. Define el resultado esperado
¿Qué debería producir el modelo?
3. Pregunta si conocemos ese resultado en ejemplos históricos
Si sí, probablemente estamos dentro de un problema supervisado.
4. Observa qué representa la salida
Categoría → Clasificación
Cantidad → Regresión
5. Si no tenemos una salida objetivo
Pregunta:
¿Queremos descubrir agrupaciones o estructura en los datos?
Si sí:
Clustering puede ser una posibilidad.
6. Define cómo evaluarás el resultado
¿Qué significaría que funcionara suficientemente bien?
7. Pregunta nuevamente si necesitas machine learning
Una regla o procedimiento tradicional podría resolver algunos problemas de manera más sencilla.
Nuestro árbol mental queda:
¿Tenemos un objetivo conocido que queremos predecir?
Sí → ¿Categoría o cantidad?
Categoría → Clasificación
Cantidad → Regresión
No → ¿Queremos descubrir grupos?
Sí → Clustering
Y si ninguna encaja:
el problema puede necesitar otra formulación u otro tipo de solución.
🚦 No Fuerces el Problema Dentro de Estas Tres Cajas
Clasificación, regresión y clustering son extremadamente útiles, pero no representan todo machine learning.
Existen tareas relacionadas con:
- reducción de dimensionalidad;
- detección de anomalías;
- recomendación;
- generación;
- aprendizaje por refuerzo;
- predicción de secuencias;
- representación de información;
entre muchas otras.
Algunas pueden relacionarse o combinarse con los conceptos que estamos aprendiendo.
Por eso esta lección no pretende decir:
“Todo problema de IA es clasificación, regresión o clustering.”
Su propósito es proporcionarnos tres estructuras fundamentales para comenzar a reconocer problemas de aprendizaje con datos.
📝 Comprueba lo que Aprendiste
- ¿Qué resultado produce normalmente una tarea de clasificación?
- ¿Qué resultado buscamos normalmente mediante regresión?
- ¿Qué intenta descubrir clustering?
- ¿Clasificación pertenece normalmente al aprendizaje supervisado?
- ¿Regresión pertenece normalmente al aprendizaje supervisado?
- ¿Clustering se relaciona normalmente con aprendizaje no supervisado?
- ¿Por qué una salida numérica no significa automáticamente regresión?
- ¿Cuál es la diferencia entre clasificación y clustering?
- ¿Los mismos datos pueden utilizarse para formular problemas diferentes?
- ¿Por qué debemos definir el resultado antes de seleccionar un algoritmo?
- ¿Cómo cambia la evaluación entre clasificación, regresión y clustering?
- ¿Por qué no todos los errores tienen la misma importancia?
- ¿Una probabilidad producida por un clasificador convierte automáticamente el problema en regresión?
- ¿Por qué no debemos forzar todos los problemas dentro de estas tres tareas?
- ¿Qué pregunta deberíamos hacer antes de elegir un modelo?
Si puedes observar una necesidad y distinguir entre:
categoría, cantidad y agrupación
ya tienes una herramienta práctica para formular problemas de machine learning.
📌 Ideas Clave de la Lección
- Clasificación, regresión y clustering resuelven tipos diferentes de problemas.
- Clasificación busca predecir una categoría previamente definida.
- Regresión busca estimar un valor numérico.
- Clustering busca descubrir agrupaciones o estructura en los datos.
- Clasificación y regresión se relacionan habitualmente con aprendizaje supervisado.
- Clustering es una tarea característica del aprendizaje no supervisado.
- Un número puede representar una categoría; no toda salida numérica implica regresión.
- Clasificación y clustering pueden producir grupos, pero no los obtienen de la misma manera.
- El mismo conjunto de datos puede utilizarse para formular problemas diferentes.
- El tipo de tarea depende de la pregunta y del resultado que necesitamos.
- La evaluación debe corresponder a la naturaleza del problema.
- Los errores deben interpretarse según sus consecuencias reales.
- Debemos identificar la tarea antes de seleccionar un algoritmo.
- No todos los problemas requieren machine learning.
- Clasificación, regresión y clustering no representan todas las posibilidades de machine learning.
🎯 Lo Que Ahora Eres Capaz de Hacer
Ya no necesitas escuchar el nombre de un algoritmo para comenzar a analizar un problema.
Puedes empezar por algo mucho más útil:
¿Qué resultado necesitamos?
Si queremos:
una categoría → pensamos en clasificación.
Si queremos:
una cantidad → pensamos en regresión.
Si queremos:
descubrir agrupaciones → pensamos en clustering.
Y sabes que ésa todavía no es la decisión final.
Después tendrás que analizar:
- los datos;
- la calidad de esos datos;
- cómo evaluar el resultado;
- las consecuencias de los errores;
- qué modelo podría funcionar;
- cómo se integrará en una solución.
Pero ya puedes realizar uno de los pasos más importantes:
convertir una necesidad real en un problema de aprendizaje mejor definido.
🧭 Del Problema al Tipo de Aprendizaje
En las últimas lecciones hemos construido una cadena conceptual:
Problema → Datos → Aprendizaje → Modelo → Resultado
Ahora podemos añadir:
Problema → Resultado necesario → Tipo de tarea → Datos → Modelo → Evaluación
Ésta es una evolución importante.
Ya no comenzamos pensando:
“Quiero utilizar machine learning.”
Comenzamos preguntando:
“¿Qué problema quiero resolver y qué resultado necesito obtener?”
A partir de ahí podemos decidir si necesitamos predecir una categoría, estimar una cantidad, descubrir agrupaciones o utilizar otro enfoque diferente.