Lección 11 — Machine Learning Supervisado vs. No Supervisado: Cuál Es la Diferencia

aprendizaje supervisado vs no supervisado

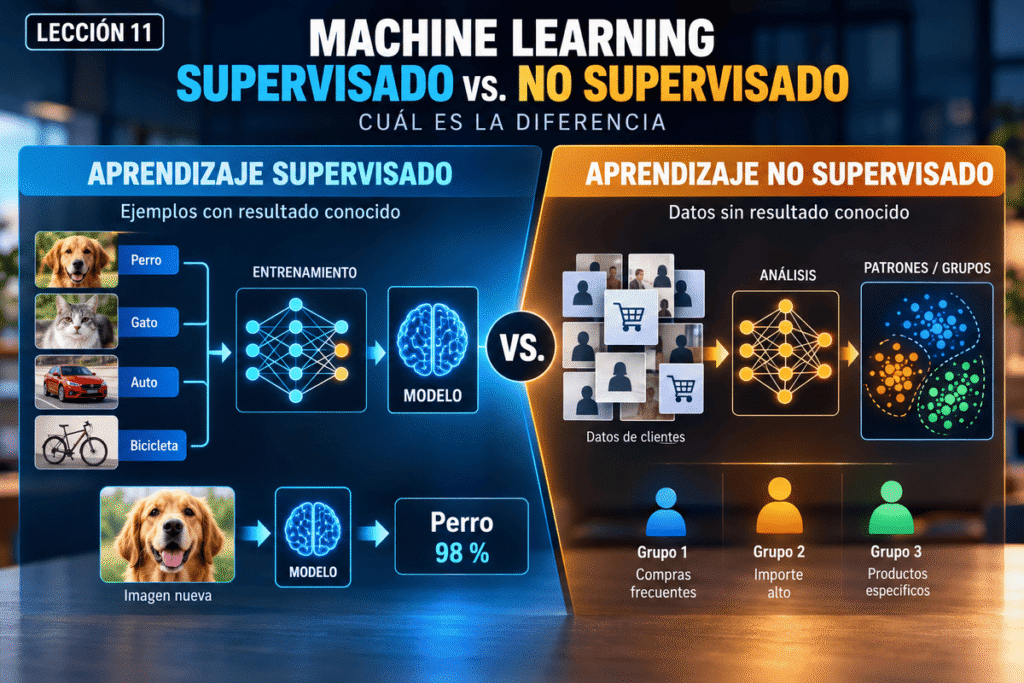
Comprender la diferencia entre aprendizaje supervisado vs no supervisado nos permite reconocer dos formas distintas de aprender a partir de datos. En el aprendizaje supervisado disponemos de ejemplos que incluyen información sobre el resultado que queremos aprender a predecir; en el aprendizaje no supervisado buscamos descubrir estructuras, agrupaciones o patrones sin proporcionar de la misma manera una respuesta objetivo conocida para cada ejemplo.

La diferencia puede parecer sencilla, pero tiene consecuencias importantes. No se trata solamente de escoger entre dos técnicas: primero debemos preguntarnos qué información tenemos disponible y qué problema queremos resolver.

Podemos comenzar con esta idea:

Aprendizaje supervisado → conocemos ejemplos de entradas y el resultado que queremos aprender a producir.

Aprendizaje no supervisado → tenemos datos y queremos descubrir estructura o patrones sin disponer de esa misma respuesta objetivo previamente definida para cada ejemplo.


🎯 Qué Aprenderás en Esta Lección

Al finalizar esta lección podrás:

  • explicar qué es el aprendizaje supervisado;
  • explicar qué es el aprendizaje no supervisado;
  • reconocer la diferencia fundamental entre ambos;
  • comprender qué papel desempeña la respuesta objetivo durante el aprendizaje supervisado;
  • identificar situaciones donde queremos predecir un resultado conocido;
  • reconocer situaciones donde queremos explorar estructura dentro de los datos;
  • distinguir entre predecir una categoría existente y descubrir posibles grupos;
  • evitar la simplificación de pensar que “supervisado” significa que una persona observa continuamente el aprendizaje;
  • analizar un problema antes de decidir qué enfoque podría resultar apropiado.

La capacidad práctica que buscamos desarrollar es:

observar los datos disponibles y el resultado que necesitamos para reconocer si el problema apunta hacia aprendizaje supervisado, aprendizaje no supervisado o si todavía no tenemos suficiente información para decidir.


🧠 ¿Por Qué Existen Diferentes Formas de Aprender?

En las lecciones anteriores estudiamos una idea general:

Datos → Entrenamiento → Modelo

Pero no todos los datos contienen la misma información y no todos los problemas buscan el mismo resultado.

Imagina dos empresas.

Empresa A

Tiene miles de mensajes históricos y cada uno ya está identificado como:

  • ventas;
  • soporte;
  • facturación.

Quiere aprender a clasificar mensajes nuevos dentro de esas categorías.

Empresa B

Tiene información sobre miles de clientes, pero no dispone de categorías previamente definidas.

Quiere investigar:

¿Existen grupos de clientes con comportamientos similares?

Ambas empresas tienen datos.

Ambas podrían utilizar machine learning.

Pero están intentando aprender cosas diferentes.

La primera conoce el tipo de resultado que desea predecir.

La segunda quiere descubrir estructura que todavía no ha definido de esa manera.

Ahí comienza la diferencia entre aprendizaje supervisado y no supervisado.


🏷️ ¿Qué Es el Aprendizaje Supervisado?

En aprendizaje supervisado entrenamos utilizando ejemplos en los que disponemos de entradas y de un resultado objetivo conocido asociado a ellas.

Por ejemplo:

MensajeCategoría conocida
“Quiero conocer sus precios”Ventas
“No puedo iniciar sesión”Soporte
“Me cobraron dos veces”Facturación

Tenemos dos componentes:

Entrada → mensaje

Objetivo conocido → categoría

El modelo utiliza muchos ejemplos para aprender relaciones entre las características de las entradas y los resultados correspondientes.

Después llega algo nuevo:

“Necesito corregir los datos de mi factura.”

El modelo podría producir:

Facturación

Podemos representar el proceso de manera simplificada:

Entradas + resultados conocidos → Entrenamiento → Modelo

Después:

Entrada nueva → Modelo → Resultado predicho


👀 ¿Quién Está “Supervisando”?

El nombre puede provocar una interpretación equivocada.

Aprendizaje supervisado no significa necesariamente que una persona esté mirando al modelo mientras aprende.

La “supervisión” se refiere a que durante el entrenamiento existe información que orienta qué resultado queremos que el modelo aprenda a producir.

Por ejemplo:

Imagen → Perro

Imagen → Gato

Mensaje → Spam

Mensaje → No spam

Vivienda → Precio conocido

Los ejemplos proporcionan una referencia con la que puede compararse el resultado del modelo durante el aprendizaje.

Por tanto, cuando escuches:

aprendizaje supervisado

piensa:

Tenemos ejemplos donde conocemos el resultado objetivo.


🏷️ ¿Qué Es una Etiqueta?

En muchos problemas supervisados, el resultado conocido recibe el nombre de etiqueta (label).

Por ejemplo:

Fotografía de un perro → etiqueta: perro

Fotografía de un gato → etiqueta: gato

Correo comercial no solicitado → etiqueta: spam

Pero debemos evitar una simplificación.

No todos los resultados supervisados son necesariamente categorías expresadas mediante palabras.

Imagina:

Vivienda A → $2,100,000

Vivienda B → $3,400,000

Vivienda C → $1,850,000

Aquí conocemos el resultado objetivo de cada ejemplo, pero es un valor numérico.

Por eso es más preciso pensar:

aprendizaje supervisado = ejemplos con una salida u objetivo conocido

y no simplemente:

aprendizaje supervisado = datos con nombres o categorías.


🏠 Ejemplo: Aprender a Estimar un Precio

Supongamos que tenemos información histórica sobre viviendas.

Para cada una conocemos:

  • superficie;
  • número de habitaciones;
  • ubicación;
  • antigüedad;
  • precio de venta.

Queremos utilizar esa información para estimar el precio de una vivienda nueva.

Durante el entrenamiento tenemos:

Características de vivienda → Precio conocido

Después:

Características de vivienda nueva → Modelo → Precio estimado

Estamos utilizando ejemplos donde el resultado objetivo era conocido.

Por tanto, estamos ante un problema compatible con aprendizaje supervisado.

En la siguiente lección aprenderemos que este tipo de tarea está relacionado con la regresión.

Por ahora basta con reconocer por qué es supervisado.


📧 Otro Ejemplo: Clasificar Mensajes

Regresemos a los mensajes de clientes.

Tenemos 20,000 ejemplos históricos ya clasificados como:

  • ventas;
  • soporte;
  • facturación;
  • reclamaciones.

Queremos que un modelo aprenda a clasificar mensajes nuevos.

Los datos de entrenamiento contienen:

Mensaje + Categoría conocida

Después:

Mensaje nuevo → Modelo → Categoría predicha

Nuevamente:

sabemos qué resultado queríamos para los ejemplos utilizados durante el entrenamiento.

En la siguiente lección veremos que este tipo de tarea corresponde a clasificación.

Aquí nos interesa únicamente reconocer la estructura supervisada del problema.


🔎 ¿Qué Es el Aprendizaje No Supervisado?

Ahora eliminemos algo importante.

Tenemos datos, pero no proporcionamos una respuesta objetivo conocida equivalente para cada ejemplo.

Imaginemos información de 50,000 clientes:

  • frecuencia de compra;
  • importe promedio;
  • tipos de productos;
  • tiempo desde la última compra;
  • número de pedidos.

Pero no tenemos categorías como:

  • cliente tipo A;
  • cliente tipo B;
  • cliente tipo C.

Queremos explorar los datos y descubrir:

¿Existen clientes con comportamientos similares?

Aquí el problema es diferente.

No estamos diciendo al sistema:

“Ésta es la respuesta correcta para cada cliente.”

Estamos buscando estructura presente en los datos.

De forma simplificada:

Datos → Aprendizaje no supervisado → Patrones/Estructura


🧩 Descubrir en Lugar de Predecir una Respuesta Conocida

Esta diferencia es central.

En aprendizaje supervisado podemos preguntar:

“Basándote en estos ejemplos donde conocemos la respuesta, ¿qué respuesta corresponde a este nuevo caso?”

En aprendizaje no supervisado podemos plantear algo como:

“Analiza estos datos y encuentra estructura o relaciones que puedan resultar útiles.”

Esto puede utilizarse, dependiendo del problema, para:

  • encontrar agrupaciones;
  • identificar estructuras;
  • explorar similitudes;
  • representar los datos de formas más útiles;
  • detectar determinados patrones.

No significa que el sistema mágicamente descubra “la verdad escondida” en los datos.

Encontrará estructura de acuerdo con:

  • los datos disponibles;
  • las características utilizadas;
  • el método seleccionado;
  • las configuraciones;
  • el criterio empleado.

Por eso los resultados todavía necesitan interpretación y evaluación.


🛒 Ejemplo: Descubrir Grupos de Clientes

Supongamos que administramos una tienda.

Tenemos información de clientes, pero nunca los hemos dividido en segmentos.

Queremos investigar si existen grupos con comportamientos similares.

Después del análisis podrían aparecer agrupaciones como:

Grupo 1

  • compra frecuentemente;
  • importe medio;
  • gran variedad de productos.

Grupo 2

  • compra pocas veces;
  • importe alto;
  • categorías específicas.

Grupo 3

  • compras pequeñas;
  • alta frecuencia;
  • productos recurrentes.

Lo importante es que no comenzamos proporcionando esos tres grupos como respuestas correctas.

El objetivo era descubrir agrupaciones basadas en similitudes presentes en los datos.

En la siguiente lección estudiaremos con mayor detalle el concepto de clustering.


⚠️ Los Grupos Descubiertos No Vienen con Significado Automático

Ésta es una diferencia práctica muy importante.

Supongamos que un método encuentra cuatro grupos.

Eso no significa automáticamente:

Grupo 1 = clientes excelentes

Grupo 2 = clientes problemáticos

Grupo 3 = clientes que abandonarán

Grupo 4 = clientes nuevos

Esas interpretaciones no aparecen mágicamente.

Primero debemos estudiar:

  • qué características distinguen los grupos;
  • si son suficientemente diferentes;
  • si permanecen razonablemente estables;
  • si tienen utilidad para el problema;
  • si nuestra interpretación está respaldada por los datos.

Un algoritmo puede descubrir agrupaciones matemáticas.

Convertirlas en conocimiento útil requiere análisis.


⚖️ Supervisado vs. No Supervisado: Comparación Directa

CaracterísticaAprendizaje supervisadoAprendizaje no supervisado
DatosEntradas con resultado objetivo conocidoDatos sin esa respuesta objetivo proporcionada de la misma manera
Pregunta típica¿Qué resultado corresponde a un nuevo caso?¿Qué estructura o patrones existen en estos datos?
ObjetivoAprender una relación para predecir resultadosDescubrir estructura, similitudes o relaciones
EjemploPredecir si un mensaje es spamEncontrar grupos de mensajes similares
EvaluaciónPodemos comparar predicción con resultado conocidoLa utilidad de la estructura encontrada requiere otros criterios
Tareas relacionadasClasificación y regresiónClustering y otras técnicas exploratorias

La tabla ayuda a comparar, pero no debemos convertirla en una receta automática.

La pregunta decisiva sigue siendo:

¿Qué problema queremos resolver y qué información tenemos disponible?


🧠 El Mismo Conjunto de Datos Puede Plantear Problemas Diferentes

Éste es uno de los puntos más útiles de la lección.

Supongamos que tenemos información de clientes.

Problema A

Queremos predecir cuáles cancelarán su suscripción.

Tenemos datos históricos donde sabemos quién canceló y quién no.

Tenemos:

Cliente → Canceló / No canceló

Esto puede plantearse como aprendizaje supervisado.

Problema B

Queremos descubrir si existen diferentes perfiles de comportamiento.

No tenemos esos perfiles previamente definidos.

Tenemos:

Datos de clientes → Buscar agrupaciones

Esto puede plantearse como aprendizaje no supervisado.

Observa:

los datos pueden ser parecidos; la pregunta es diferente.

Por eso no elegimos el enfoque únicamente observando el archivo de datos.

Primero necesitamos saber:

¿Qué queremos obtener de esos datos?


🎯 El Problema Determina Qué Significa “Respuesta”

Supongamos que tenemos fotografías de productos.

Objetivo 1

Queremos predecir:

Defectuoso / Correcto

y disponemos de fotografías históricas ya identificadas.

Tenemos un problema supervisado.

Objetivo 2

Queremos explorar las imágenes para encontrar grupos de productos visualmente similares sin categorías previamente definidas.

Tenemos un problema que podría abordarse con técnicas no supervisadas.

Objetivo 3

Queremos simplemente almacenar y buscar fotografías por número de producto.

Tal vez no necesitamos machine learning.

Este tercer caso es importante.

No debemos convertir cada conjunto de datos en un problema de IA.


🚫 No Supervisado No Significa “Sin Objetivo”

Otra confusión frecuente sería pensar:

“Si es no supervisado, simplemente entregamos datos al algoritmo y vemos qué pasa.”

Eso sería una mala práctica.

Aunque no tengamos una respuesta objetivo conocida para cada ejemplo, todavía necesitamos un propósito.

Por ejemplo:

Queremos encontrar grupos de clientes para comprender diferentes patrones de compra.

Tenemos una pregunta de análisis.

Después debemos evaluar si los grupos encontrados:

  • son interpretables;
  • aportan información;
  • son suficientemente distintos;
  • resultan útiles;
  • ayudan realmente a nuestro propósito.

No tener etiquetas no significa no tener objetivo.

💻 Antes de aumentar la potencia, entiende tus datos

Los proyectos de machine learning pueden crecer desde pequeños experimentos hasta análisis con conjuntos de datos mucho mayores. El equipo adecuado depende del problema, del volumen de información y del tipo de procesamiento que realmente necesites.

Empieza comprendiendo tus datos y validando la solución. Cuando el proyecto demande más memoria, almacenamiento o capacidad de procesamiento, podrás ampliar los recursos con una necesidad concreta.

Explora opciones para tus proyectos tecnológicos →

Recomendación comercial de PCUniverseOne

💻 El Tipo de Datos No Decide por Sí Solo el Enfoque

Podríamos pensar:

Imágenes = supervisado

o:

Clientes = no supervisado

Eso sería incorrecto.

Una imagen puede utilizarse en aprendizaje supervisado si conocemos la categoría objetivo.

Pero también podemos analizar colecciones de imágenes buscando estructura o similitudes sin proporcionar esas categorías de la misma manera.

Lo mismo ocurre con:

  • textos;
  • transacciones;
  • sensores;
  • clientes;
  • productos;
  • sonidos.

Por tanto:

el formato de los datos no determina automáticamente el tipo de aprendizaje.

Debemos analizar:

Datos disponibles + Información conocida + Resultado deseado


🧪 Experimento: Quita las Respuestas

Imaginemos estos datos:

MensajeCategoría
“Quiero una cotización”Ventas
“Mi contraseña no funciona”Soporte
“No reconozco este cobro”Facturación
“Quiero comprar 20 unidades”Ventas

Podemos entrenar un sistema supervisado porque conocemos las categorías.

Ahora eliminemos la segunda columna:

Mensaje
“Quiero una cotización”
“Mi contraseña no funciona”
“No reconozco este cobro”
“Quiero comprar 20 unidades”

¿Podemos entrenar exactamente el mismo problema supervisado de clasificación?

Nos falta la información que indica qué categoría debería aprender a producir para cada ejemplo.

Pero podríamos formular otra pregunta:

¿Existen mensajes suficientemente similares como para formar agrupaciones?

Los mismos textos pueden servir para otro problema de aprendizaje.

Cambió la información disponible y cambió la pregunta.


🔄 ¿Podemos Convertir un Problema No Supervisado en Supervisado?

En algunos proyectos, inicialmente tenemos muchos datos pero ninguna etiqueta útil.

Podríamos comenzar explorándolos.

Después, personas con conocimiento del problema podrían etiquetar determinados ejemplos.

Por ejemplo:

Antes:

100,000 mensajes sin clasificar.

Después:

10,000 mensajes revisados e identificados como:

  • ventas;
  • soporte;
  • facturación;
  • otros.

Ahora disponemos de ejemplos etiquetados que podrían utilizarse para un problema supervisado.

Esto nos muestra que la elección no depende únicamente de una propiedad permanente de los datos.

Los datos pueden:

  • enriquecerse;
  • etiquetarse;
  • reorganizarse;
  • complementarse.

El diseño del proyecto puede evolucionar.


💰 Las Etiquetas También Tienen un Costo

Parece sencillo decir:

“Utilicemos aprendizaje supervisado.”

Pero alguien debe proporcionar o verificar las respuestas conocidas utilizadas durante el entrenamiento.

En algunos problemas esto es fácil.

Por ejemplo, podemos tener registros históricos donde el resultado ya existe.

En otros puede ser costoso.

Imagina que necesitamos que especialistas revisen:

  • imágenes médicas;
  • documentos legales;
  • defectos industriales complejos;
  • fotografías científicas.

Crear datos correctamente etiquetados puede requerir:

  • tiempo;
  • expertos;
  • criterios claros;
  • procesos de revisión;
  • control de calidad.

Por eso la disponibilidad de datos etiquetados puede influir significativamente en el diseño de una solución.


⚠️ Una Etiqueta Puede Estar Equivocada

Tener etiquetas no garantiza que sean correctas.

Supongamos que utilizamos miles de solicitudes históricas clasificadas por empleados.

Podríamos encontrar:

  • errores;
  • criterios diferentes entre personas;
  • categorías ambiguas;
  • registros antiguos;
  • etiquetas inconsistentes.

Si utilizamos esos datos como referencia durante el entrenamiento, el modelo puede aprender parte de esas inconsistencias.

Por eso debemos preguntar:

¿Quién produjo las etiquetas?

¿Con qué criterio?

¿Qué tan confiables son?

¿Siguen representando el problema actual?

Una vez más:

los datos no se vuelven buenos simplemente porque tengan etiquetas.


🔍 ¿Cómo Evaluamos Ambos Enfoques?

En aprendizaje supervisado tenemos una ventaja conceptual importante.

Si conocemos el resultado correcto de ejemplos reservados para evaluación, podemos comparar:

Predicción del modelo ↔ Resultado real

Por ejemplo:

Real: Spam

Predicción: Spam

o:

Real: Spam

Predicción: No spam

Esto permite construir métricas para medir el desempeño.

En aprendizaje no supervisado, la situación puede ser menos directa.

Si estamos descubriendo grupos que no estaban definidos previamente, no siempre existe una única “respuesta correcta” contra la cual comparar.

Podemos necesitar evaluar:

  • coherencia;
  • separación;
  • estabilidad;
  • interpretabilidad;
  • utilidad práctica.

Esto no significa que el aprendizaje no supervisado no pueda evaluarse.

Significa que la evaluación debe corresponder al problema que realmente estamos resolviendo.


🤝 Supervisado y No Supervisado No Son Enemigos

No debemos pensar:

Supervisado vs. no supervisado = uno debe ganar.

Son enfoques que responden a necesidades diferentes.

Un proyecto podría incluso utilizar ambos en distintas etapas.

Por ejemplo:

1. Explorar datos

Podemos buscar estructuras o agrupaciones.

2. Comprender los resultados

Especialistas analizan lo encontrado.

3. Crear categorías útiles

Se definen etiquetas.

4. Construir un sistema predictivo

Posteriormente se entrena un modelo supervisado.

La elección depende del problema, los datos y el objetivo.

No de cuál técnica esté más de moda.


🧪 Actividad Práctica: ¿Supervisado o No Supervisado?

Clasifica conceptualmente cada situación.

Caso A

Tenemos 100,000 correos históricos identificados como:

Spam / No spam

Queremos clasificar correos nuevos.

Caso B

Tenemos datos de compras de 40,000 clientes.

Queremos descubrir grupos con comportamientos similares y no tenemos esos grupos definidos previamente.

Caso C

Tenemos información histórica de viviendas y conocemos su precio de venta.

Queremos estimar el precio de viviendas nuevas.

Caso D

Tenemos miles de documentos sin categorías y queremos explorar si existen agrupaciones temáticas.

Caso E

Tenemos fotografías de piezas industriales ya identificadas como:

Correcta / Defectuosa

Queremos analizar fotografías nuevas.

Intenta responder antes de continuar.


✅ Analicemos las Respuestas

Caso A — Supervisado

Tenemos ejemplos con una categoría conocida:

Spam / No spam

y queremos predecirla para nuevos casos.

Caso B — No supervisado

No disponemos de los grupos objetivo previamente definidos.

Queremos descubrir estructura en los datos.

Caso C — Supervisado

Conocemos el precio histórico y queremos aprender una relación que permita estimarlo para casos nuevos.

Caso D — No supervisado

Buscamos descubrir posibles agrupaciones sin categorías objetivo previamente proporcionadas.

Caso E — Supervisado

Disponemos de fotografías con resultados conocidos:

Correcta / Defectuosa

y queremos predecir la categoría para nuevas imágenes.

Pero recuerda:

reconocer el enfoque es solamente el comienzo.

Todavía tendríamos que analizar la calidad de los datos, la utilidad de la tarea y cómo evaluaremos los resultados.


🕵️ Caso Más Difícil: Clientes que Podrían Abandonar

Una empresa dice:

“Queremos utilizar IA para encontrar clientes que podrían abandonar nuestro servicio.”

¿Supervisado o no supervisado?

Todavía no tenemos suficiente información.

Debemos preguntar:

¿Tenemos datos históricos que indiquen qué clientes abandonaron y cuáles permanecieron?

Si la respuesta es sí, podríamos formular un problema supervisado:

Características del cliente → Abandona / No abandona

Pero si no tenemos ese resultado histórico y simplemente queremos explorar diferentes patrones de comportamiento, quizá el problema inicial sea distinto.

La enseñanza importante es:

No clasifiques el problema demasiado pronto. Primero pregunta qué datos existen y qué resultado necesitamos.

Éste es criterio profesional.


🧭 Método Práctico para Elegir el Enfoque

Cuando encuentres un posible problema de machine learning, sigue este proceso.

1. Define el problema

¿Qué queremos resolver?

2. Define el resultado

¿Qué queremos que produzca el sistema?

3. Examina los datos

¿Qué información tenemos?

4. Busca el objetivo conocido

¿Tenemos ejemplos donde conocemos el resultado que queremos aprender a predecir?

Sí → podría ser supervisado.

5. Si no existe ese objetivo

Pregunta:

¿Queremos descubrir estructura, agrupaciones o relaciones dentro de los datos?

Sí → podría ser no supervisado.

6. Pregunta si realmente necesitamos machine learning

Tal vez una solución más sencilla sea suficiente.

7. Define cómo evaluarás el resultado

No implementes un método si no sabes qué significaría que fuera útil.

Podemos resumirlo:

Problema → Resultado deseado → Datos disponibles → Tipo de aprendizaje → Evaluación

No:

Algoritmo de moda → buscar dónde utilizarlo.


🛠️ Mini Práctica: Formula Dos Problemas con los Mismos Datos

Imagina que tienes una base con información de 20,000 productos:

  • precio;
  • categoría comercial;
  • frecuencia de venta;
  • devoluciones;
  • margen;
  • inventario.

Ahora formula dos problemas diferentes.

Problema supervisado

Elige un resultado histórico conocido que quieras predecir.

Por ejemplo:

¿Qué productos tendrán alta demanda el próximo periodo?

¿Qué información histórica necesitarías?

Problema no supervisado

Elimina esa respuesta objetivo.

Ahora pregunta:

¿Qué estructura queremos descubrir?

Por ejemplo:

¿Existen grupos de productos con comportamientos comerciales similares?

Después compara ambos.

Los datos pueden provenir de la misma empresa.

Pero:

la pregunta transforma el problema.


📝 Comprueba lo que Aprendiste

  1. ¿Qué es el aprendizaje supervisado?
  2. ¿Qué es el aprendizaje no supervisado?
  3. ¿Qué significa “supervisión” en aprendizaje supervisado?
  4. ¿Necesita existir una persona observando continuamente el entrenamiento?
  5. ¿Qué es una etiqueta?
  6. ¿El resultado objetivo supervisado tiene que ser siempre una categoría?
  7. ¿Cuál es la diferencia fundamental entre predecir una categoría conocida y descubrir grupos?
  8. ¿No supervisado significa trabajar sin ningún objetivo?
  9. ¿El tipo de dato determina automáticamente el enfoque?
  10. ¿Los mismos datos pueden utilizarse para formular problemas diferentes?
  11. ¿Por qué obtener etiquetas puede resultar costoso?
  12. ¿Qué ocurre si las etiquetas contienen errores?
  13. ¿Por qué puede ser diferente la evaluación en aprendizaje supervisado y no supervisado?
  14. ¿Pueden ambos enfoques utilizarse dentro de un mismo proyecto?
  15. ¿Qué deberías preguntar antes de decidir cuál utilizar?

Si tu primera pregunta es:

“¿Qué queremos obtener y qué información conocemos ya?”

estás razonando en la dirección correcta.


📌 Ideas Clave de la Lección

  • El aprendizaje supervisado utiliza ejemplos con un resultado objetivo conocido.
  • “Supervisado” no significa necesariamente que una persona observe continuamente al modelo.
  • Las etiquetas pueden representar categorías, pero los objetivos también pueden ser valores numéricos.
  • El aprendizaje no supervisado busca estructura o patrones sin proporcionar de la misma manera una respuesta objetivo conocida para cada ejemplo.
  • No supervisado no significa trabajar sin propósito.
  • Los grupos descubiertos no poseen automáticamente un significado empresarial o humano.
  • El mismo tipo de datos puede utilizarse en problemas supervisados o no supervisados.
  • La pregunta que queremos responder es tan importante como los datos disponibles.
  • Obtener etiquetas puede requerir trabajo y conocimiento especializado.
  • Las etiquetas pueden contener errores e inconsistencias.
  • La evaluación debe adaptarse al tipo de problema.
  • Supervisado y no supervisado no compiten; resuelven necesidades diferentes.
  • Un proyecto puede combinar ambos enfoques.
  • Antes de escoger una técnica debemos definir el problema, el resultado deseado y los datos disponibles.


🎯 Lo Que Ahora Eres Capaz de Hacer

Antes de esta lección sabías que un modelo aprende patrones a partir de datos.

Ahora puedes observar un problema y hacer una distinción mucho más útil.

Puedes preguntar:

¿Conocemos el resultado que queremos aprender a predecir para nuestros ejemplos?

Si la respuesta es sí, puedes reconocer un posible problema de aprendizaje supervisado.

Si no conocemos esa respuesta y nuestro objetivo es descubrir estructura o agrupaciones dentro de los datos, puedes reconocer un posible problema de aprendizaje no supervisado.

Y, todavía más importante, sabes que no debes decidir únicamente porque alguien diga:

“Tenemos muchos datos.”

Primero necesitas saber:

qué contienen esos datos y qué problema queremos resolver con ellos.

Eso es aplicar machine learning con criterio.


🧭 Continúa Tu Ruta de Aprendizaje

Ya podemos distinguir dos grandes formas de aprender a partir de datos.

Ahora necesitamos avanzar un nivel y comprender qué tipo de tarea queremos que realice el modelo.

Así podremos distinguir cuándo queremos:

asignar una categoría, estimar un valor o descubrir agrupaciones.


← Lección Anterior     Índice del Programa     Siguiente Lección →

Scroll to Top