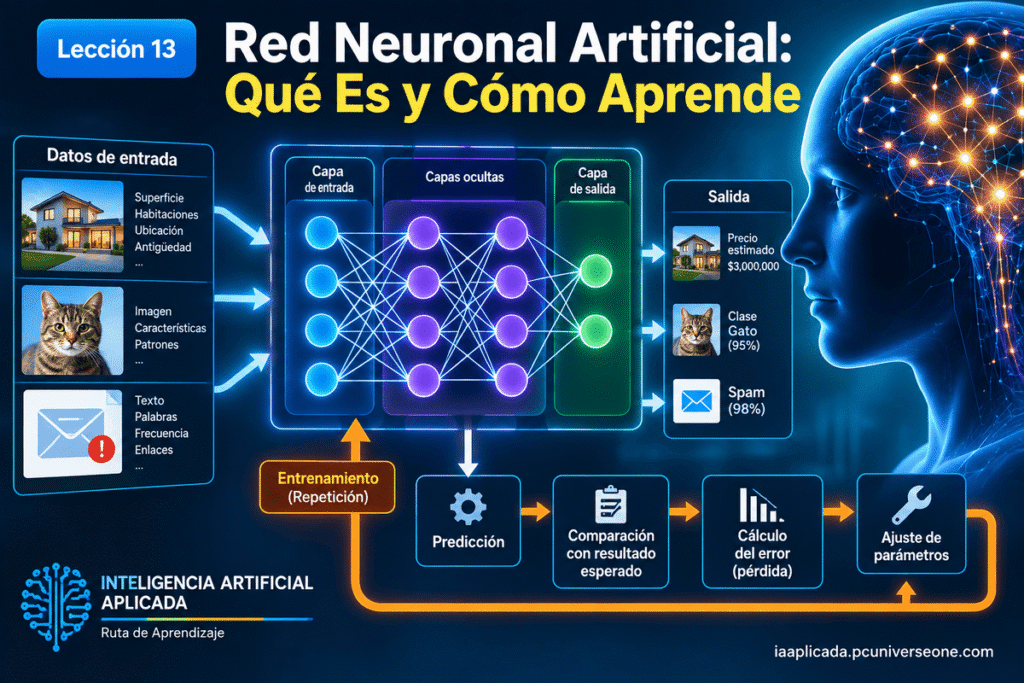
Lección 13 — Red Neuronal Artificial: Qué Es y Cómo Aprende

Red Neuronal

Una red neuronal es un modelo de inteligencia artificial capaz de aprender relaciones entre datos mediante el ajuste progresivo de numerosos parámetros internos. Una red neuronal artificial recibe información de entrada, la procesa a través de unidades conectadas entre sí y genera una salida. Durante el entrenamiento, compara sus resultados con los esperados y modifica sus parámetros para intentar reducir sus errores.

La idea puede parecer complicada al principio porque términos como neuronas, capas, pesos y entrenamiento suelen presentarse acompañados de fórmulas matemáticas. Sin embargo, para comprender cómo se utiliza una red neuronal en inteligencia artificial, primero necesitamos entender qué ocurre conceptualmente dentro de ella y qué significa realmente que “aprenda”.

En esta lección construiremos esa comprensión paso a paso.


🎯 Qué Aprenderás en Esta Lección

Al terminar esta lección podrás:

  • Explicar qué es una red neuronal artificial.
  • Identificar sus componentes fundamentales: entradas, neuronas, conexiones, pesos, sesgos y salida.
  • Comprender cómo circula la información a través de una red neuronal.
  • Explicar qué significa que una red neuronal “aprenda”.
  • Comprender el papel del error durante el entrenamiento.
  • Distinguir entre entrenamiento y utilización de una red ya entrenada.
  • Reconocer problemas en los que una red neuronal puede resultar útil.
  • Evitar la idea equivocada de que una red neuronal artificial piensa como un cerebro humano.

La capacidad práctica que buscamos no es que programes todavía una red neuronal desde cero, sino que entiendas suficientemente bien su funcionamiento para interpretar qué hace, cómo aprende y qué significa utilizar una en una solución de inteligencia artificial.


🧠 ¿Qué Es una Red Neuronal Artificial?

Una red neuronal artificial es un modelo computacional formado por unidades conectadas que procesan información.

Estas unidades suelen denominarse neuronas artificiales.

Cada neurona recibe determinados valores, realiza operaciones con ellos y produce un resultado que puede convertirse en entrada para otras neuronas.

Una representación conceptual sencilla sería:

Datos de entrada → neuronas → procesamiento → resultado

Sin embargo, lo verdaderamente importante no es solamente que exista esa estructura.

La característica fundamental es que muchas de las conexiones de la red contienen parámetros que pueden ajustarse durante el entrenamiento.

Gracias a esos ajustes, la red puede modificar la manera en que transforma las entradas en resultados.

Por ejemplo, una red neuronal podría recibir información sobre una vivienda:

  • superficie;
  • número de habitaciones;
  • ubicación;
  • antigüedad;
  • características adicionales.

Y producir como resultado una estimación de su precio.

Otra podría recibir una imagen y producir una estimación de qué objeto aparece en ella.

La red no necesita que un programador escriba una regla específica para cada combinación posible de características. Durante el entrenamiento intenta aprender relaciones útiles a partir de ejemplos.


🧩 ¿Por Qué se Llaman Redes “Neuronales”?

El nombre proviene de una inspiración histórica en las neuronas y conexiones del sistema nervioso biológico.

Pero esta analogía debe utilizarse con cuidado.

Una neurona artificial no es una reproducción completa de una neurona biológica, y una red neuronal artificial tampoco es una copia digital del cerebro humano.

En términos prácticos, una neurona artificial es una unidad matemática y computacional que:

  • recibe valores;
  • asigna diferente importancia a esos valores;
  • los combina;
  • aplica una transformación;
  • produce una salida.

Por eso, cuando hablamos de una red neuronal que “aprende”, no estamos diciendo que comprenda el mundo o aprenda de la misma manera que una persona.

Estamos describiendo un proceso de ajuste de parámetros basado en datos y errores.

Esta distinción será importante durante todo el programa: utilizar palabras tomadas del comportamiento humano puede facilitar una explicación, pero no debemos confundir la metáfora con el funcionamiento real del sistema.


🔗 La Idea Fundamental: Muchas Unidades Conectadas

Imagina que queremos determinar si un mensaje de correo electrónico probablemente es spam.

Podríamos proporcionar al modelo diferentes características del mensaje:

  • palabras utilizadas;
  • frecuencia de determinados términos;
  • presencia de enlaces;
  • características del remitente;
  • estructura del mensaje;
  • otros patrones presentes en los datos.

Una sola señal podría ser insuficiente.

Por ejemplo, que aparezca la palabra “oferta” no significa automáticamente que un mensaje sea spam.

La utilidad de una red neuronal surge de poder combinar numerosas señales y aprender qué importancia debe tener cada una para producir un resultado.

Podemos visualizar la idea de esta manera:

Entradas → combinaciones y transformaciones → salida

La estructura interna puede contener muchas conexiones, y cada conexión puede contribuir de manera diferente al resultado final.


🏗️ Las Capas de una Red Neuronal

Una red neuronal básica puede entenderse mediante tres tipos de capas:

  • Capa de entrada: recibe los datos.
  • Una o más capas intermedias u ocultas: transforman la información.
  • Capa de salida: produce el resultado.

Veamos qué significa cada una.


📥 Capa de Entrada

La capa de entrada representa la información que proporcionamos al modelo.

Supongamos que queremos estimar el precio de una vivienda utilizando tres características:

  • superficie;
  • número de habitaciones;
  • antigüedad.

Conceptualmente podríamos tener:

Superficie → entrada 1
Habitaciones → entrada 2
Antigüedad → entrada 3

Estas entradas serán procesadas por la red.

En problemas reales pueden existir decenas, cientos, miles o incluso más elementos de información, dependiendo del tipo de datos y del problema.


⚙️ Capas Ocultas

Entre la entrada y la salida pueden existir una o más capas llamadas capas ocultas.

“Oculta” no significa misteriosa ni inaccesible.

Simplemente significa que no corresponde directamente ni a los datos originales de entrada ni al resultado final.

En estas capas se realizan transformaciones que permiten a la red construir representaciones útiles para resolver el problema.

Conceptualmente:

Entrada → transformación → transformación → salida

Cuanto más compleja sea la arquitectura, más transformaciones pueden intervenir.

Sin embargo, más capas no significa automáticamente mejor modelo.

En la siguiente lección estudiaremos específicamente qué ocurre cuando estas estructuras adquieren mayor profundidad y por qué aparece el concepto de deep learning. Aquí nos interesa primero comprender el mecanismo fundamental de una red neuronal.


📤 Capa de Salida

La capa de salida genera el resultado de la red.

El tipo de salida depende del problema.

Por ejemplo:

  • una categoría;
  • una probabilidad;
  • un valor numérico;
  • varias probabilidades correspondientes a diferentes categorías.

Si estamos clasificando una imagen, la salida podría indicar qué categoría considera más probable la red.

Si estamos estimando el precio de una vivienda, podría producir un valor numérico.

Esto conecta directamente con lo aprendido en la lección anterior: clasificación y regresión describen tipos de problemas, mientras que una red neuronal es una de las familias de modelos que pueden utilizarse para resolver determinados problemas.


⚖️ Los Pesos: No Todas las Entradas Importan Igual

Uno de los conceptos más importantes para comprender una red neuronal es el de peso.

Un peso representa, de forma simplificada, cuánto influye una determinada señal dentro de una conexión.

Supongamos que intentamos estimar el precio de una vivienda.

Podríamos descubrir que:

  • la superficie tiene una influencia importante;
  • la ubicación también;
  • determinada característica tiene una influencia menor.

La red no recibe necesariamente esas importancias escritas manualmente.

Durante el entrenamiento puede ajustar sus pesos para encontrar combinaciones que reduzcan sus errores.

Podemos imaginar una operación simplificada:

entrada × peso → contribución al resultado

Si una neurona recibe varias entradas, combinará diferentes contribuciones.

No necesitamos realizar ahora el cálculo matemático completo. Lo importante es comprender la idea:

Los pesos son parámetros ajustables que permiten modificar la influencia de las conexiones dentro de la red.

Y precisamente modificar esos parámetros constituye una parte esencial del aprendizaje.


🎚️ El Sesgo o Bias

Además de los pesos, las neuronas suelen incluir otro parámetro denominado sesgo o bias.

El sesgo permite desplazar el comportamiento de una neurona y aporta flexibilidad adicional al modelo.

Una representación conceptual sería:

entradas ponderadas + sesgo → transformación → salida

Aquí conviene evitar una confusión terminológica.

El bias de una neurona es un parámetro matemático del modelo. No es necesariamente lo mismo que hablar de sesgo en inteligencia artificial como problema relacionado con datos, resultados injustos o distorsiones sistemáticas.

Son conceptos diferentes que comparten una traducción similar.


🔀 La Función de Activación

Si las neuronas únicamente realizaran determinadas combinaciones lineales una tras otra, la capacidad de la red para representar relaciones complejas estaría limitada.

Por eso aparecen las funciones de activación.

Una función de activación transforma el valor calculado por una neurona antes de transmitirlo hacia adelante.

De forma conceptual:

Entradas → pesos → combinación → activación → salida de la neurona

Existen distintas funciones de activación y su elección depende de la arquitectura y del problema.

No necesitamos memorizar sus fórmulas en esta etapa.

Lo importante es entender para qué están ahí: permiten introducir transformaciones que ayudan a la red a representar relaciones más complejas que una simple combinación lineal.


🧮 Una Neurona Artificial Paso a Paso

Podemos reunir ahora los conceptos anteriores.

Supongamos que una neurona recibe tres entradas:

x₁, x₂, x₃

Cada una tiene asociado un peso:

w₁, w₂, w₃

Conceptualmente ocurre algo parecido a:

Entradas × pesos → combinación + sesgo → función de activación → salida

Es decir:

  1. La neurona recibe valores.
  2. Cada entrada se combina con un peso.
  3. Las contribuciones se integran.
  4. Se incorpora un sesgo.
  5. Se aplica una función de activación.
  6. Se genera una salida.

Esa salida puede dirigirse a otras neuronas.

Una red aparece cuando muchas de estas unidades están organizadas y conectadas entre sí.


🔄 Cómo Circula la Información por una Red Neuronal

Cuando introducimos un ejemplo en una red, los datos avanzan desde la entrada hasta la salida.

De manera simplificada:

Datos → capa de entrada → capa oculta → salida

Si existen varias capas intermedias:

Datos → entrada → capa oculta 1 → capa oculta 2 → … → salida

En cada etapa se realizan transformaciones utilizando los parámetros actuales del modelo.

Este recorrido hacia adelante permite producir una predicción.

Por ejemplo:

Datos de una vivienda → red neuronal → precio estimado

Hasta este momento, la red solamente ha calculado una salida.

Todavía falta explicar la parte esencial:

¿cómo aprende?


🎓 ¿Qué Significa que una Red Neuronal Aprende?

Una red neuronal aprende cuando sus parámetros se modifican durante el entrenamiento de manera que pueda mejorar su desempeño respecto del objetivo definido.

Podemos resumir el proceso así:

Ejemplo → predicción → comparación → error → ajuste → nuevo intento

Y repetirlo muchas veces.

Esta idea es mucho más importante que memorizar inicialmente los nombres de todos los algoritmos involucrados.

Veamos el proceso con un ejemplo.


🏠 Ejemplo: Aprender a Estimar el Precio de una Vivienda

Supongamos que tenemos datos históricos de viviendas cuyo precio real conocemos.

Para una vivienda determinada sabemos:

  • superficie: 150 m²;
  • habitaciones: 3;
  • antigüedad: 8 años;
  • precio real: $3,000,000.

Introducimos las características en la red.

La red utiliza sus parámetros actuales y produce:

Precio estimado: $2,500,000

Pero conocemos el valor real:

Precio real: $3,000,000

Existe una diferencia entre ambos resultados.

Esa diferencia proporciona información sobre el error del modelo.

Conceptualmente:

Predicción → comparación con realidad → medición del error

El proceso de entrenamiento utiliza esa información para determinar cómo modificar los parámetros de la red.

Después se procesan más ejemplos y el ciclo continúa.


🎯 La Función de Pérdida: Convertir el Error en una Señal Medible

Para mejorar un modelo necesitamos alguna manera de medir qué tan equivocadas son sus predicciones.

Aquí aparece la función de pérdida (loss function).

Su función es proporcionar una medida del error de la red respecto del objetivo establecido.

Conceptualmente:

Resultado esperado + resultado producido → pérdida

Si las predicciones mejoran de acuerdo con el criterio utilizado, queremos que esa pérdida disminuya.

Por eso podemos visualizar el entrenamiento como un proceso que intenta:

reducir progresivamente la pérdida mediante el ajuste de parámetros.

Esto no significa que el objetivo sea conseguir un error absolutamente igual a cero en los datos de entrenamiento. Como veremos posteriormente en el programa, un modelo puede comportarse muy bien con los ejemplos que ya conoce y, sin embargo, funcionar mal ante datos nuevos.

Aprender no equivale a memorizar.


↩️ ¿Cómo Sabe la Red Qué Debe Ajustar?

Aquí llegamos a uno de los mecanismos fundamentales del entrenamiento de muchas redes neuronales.

Después de producir una salida y calcular el error, necesitamos saber cómo contribuyeron los parámetros de la red a ese error.

En muchas redes se utiliza un procedimiento conocido como retropropagación o backpropagation.

Sin entrar todavía en el desarrollo matemático, su función conceptual consiste en utilizar la información del error para calcular cómo deberían modificarse los parámetros de las diferentes conexiones.

Podemos imaginar dos recorridos:

Hacia adelante:
datos → procesamiento → predicción

Durante el aprendizaje:
error → cálculo de contribuciones → ajuste de parámetros

La retropropagación no significa que los datos simplemente “viajen hacia atrás” de la misma manera en que viajaron hacia adelante. Es un procedimiento matemático utilizado para calcular cómo cambia el error respecto de los parámetros de la red.

Esta precisión es importante porque la explicación simplificada no debe convertirse en una explicación incorrecta.


📉 El Ajuste No Se Hace al Azar

Saber que existe un error no basta.

Necesitamos determinar en qué dirección modificar los parámetros para intentar reducirlo.

Para ello se utilizan procedimientos de optimización. Uno de los conceptos fundamentales asociados al entrenamiento es el descenso de gradiente y existen diferentes algoritmos de optimización basados en esta idea y sus variantes.

Por ahora basta con comprender su propósito:

buscar ajustes de los parámetros que reduzcan la pérdida.

Podemos representar el ciclo completo:

Predicción → pérdida → cálculo de ajustes → actualización de parámetros → nueva predicción

Este ciclo se repite durante el entrenamiento.

💻 Recursos de cómputo para trabajar con inteligencia artificial

Entrenar o ejecutar determinados modelos de inteligencia artificial puede requerir diferentes niveles de capacidad de procesamiento, memoria y almacenamiento. Los recursos adecuados dependen siempre del modelo, los datos y el tipo de trabajo que necesitas realizar.

Antes de adquirir equipo, conviene definir primero el problema y los requisitos reales de la solución.

Consultar opciones de tecnología en PCUniverseOne →

Recomendación comercial de PCUniverseOne

🔁 Aprender Es Repetir el Ciclo Muchas Veces

Una red neuronal normalmente no aprende a resolver un problema observando un único ejemplo.

Durante el entrenamiento procesa numerosos datos y realiza repetidamente un ciclo semejante a este:

  1. Recibe ejemplos.
  2. Produce predicciones.
  3. Compara las predicciones con los objetivos correspondientes.
  4. Calcula una pérdida.
  5. Determina cómo modificar sus parámetros.
  6. Actualiza esos parámetros.
  7. Repite el proceso.

En forma compacta:

Datos → Predicción → Error → Ajuste → Repetición

Después de suficientes iteraciones, si los datos, la arquitectura, el procedimiento de entrenamiento y otros elementos son adecuados, el modelo puede aprender relaciones que le permitan responder razonablemente ante casos que no utilizó directamente para ajustar sus parámetros.

Esa última capacidad es fundamental.


🧠 Aprender No Significa Memorizar los Ejemplos

Supongamos que entrenamos una red para reconocer determinados objetos.

Si solamente recuerda exactamente las imágenes utilizadas durante el entrenamiento, su utilidad será muy limitada.

Queremos que pueda recibir una imagen nueva y reconocer patrones relevantes que le permitan producir una respuesta útil.

Esto se relaciona con un concepto fundamental de machine learning: generalización.

Generalizar significa poder utilizar lo aprendido para responder adecuadamente ante datos nuevos pertenecientes al tipo de problema para el cual fue entrenado el modelo.

Por eso:

memorizar ejemplos ≠ aprender una solución generalizable

Esta diferencia será especialmente importante cuando estudiemos posteriormente problemas como overfitting y underfitting.


🧪 Entrenamiento y Uso No Son lo Mismo

Esta distinción es esencial cuando trabajamos profesionalmente con inteligencia artificial.

Durante el entrenamiento

El sistema:

  • procesa datos de entrenamiento;
  • produce resultados;
  • calcula errores o pérdidas;
  • ajusta parámetros;
  • repite el proceso.

Cuando utilizamos el modelo entrenado

Normalmente:

  • proporcionamos una entrada nueva;
  • el modelo utiliza los parámetros ya aprendidos;
  • procesa la entrada;
  • genera una salida.

Por ejemplo:

Entrenamiento

Miles de ejemplos → ajustes de parámetros → modelo entrenado

Uso

Nueva entrada → modelo entrenado → predicción

El segundo proceso suele denominarse inferencia.

Esta distinción explica algo que veremos repetidamente en inteligencia artificial aplicada: no siempre necesitamos entrenar un modelo para utilizar inteligencia artificial.

En muchísimas aplicaciones trabajaremos con modelos que ya fueron entrenados.


🛠️ No Siempre Necesitas Construir una Red Neuronal

Comprender cómo funcionan las redes neuronales no significa que cada problema deba resolverse construyendo una desde cero.

En la práctica puedes encontrarte con varias posibilidades:

  • utilizar un modelo ya entrenado;
  • utilizar un servicio de inteligencia artificial mediante una API;
  • adaptar un modelo existente;
  • utilizar herramientas que incorporan redes neuronales internamente;
  • entrenar un modelo cuando realmente existe una necesidad que lo justifica.

Esta diferencia encaja con el enfoque de todo nuestro programa:

El problema primero. La tecnología después.

Saber que existen redes neuronales no convierte a una red neuronal en la solución automática para cualquier problema.


🚫 Una Red Neuronal No Es Siempre la Mejor Opción

Las redes neuronales pueden ser extraordinariamente útiles, pero no son una solución universal.

Dependiendo del problema, pueden existir métodos:

  • más sencillos;
  • más rápidos;
  • menos costosos;
  • más fáciles de interpretar;
  • que necesiten menos datos;
  • que requieran menos capacidad computacional.

Por ejemplo, un problema relativamente sencillo con datos tabulares podría resolverse adecuadamente mediante otros modelos de machine learning.

La pregunta profesional no debería ser:

“¿Cómo meto una red neuronal en este proyecto?”

Sino:

“¿Qué método resuelve adecuadamente este problema con los recursos, datos y restricciones disponibles?”

Esa diferencia separa el uso de una tecnología por moda de su aplicación con criterio.


🔍 ¿Qué Puede Aprender una Red Neuronal?

Dependiendo de su arquitectura, datos, entrenamiento y objetivo, las redes neuronales pueden aprender relaciones útiles para trabajar con diferentes tipos de información.

Por ejemplo, pueden participar en sistemas relacionados con:

  • imágenes;
  • texto;
  • audio;
  • voz;
  • video;
  • datos numéricos;
  • señales;
  • series de datos;
  • combinaciones de diferentes modalidades.

También pueden utilizarse en tareas como:

  • clasificación;
  • estimación de valores;
  • reconocimiento de patrones;
  • generación de contenido;
  • detección;
  • predicción;
  • procesamiento de lenguaje;
  • reconocimiento de voz.

Pero debemos evitar una conclusión incorrecta:

que una red neuronal pueda utilizarse para una tarea no significa que cualquier red neuronal pueda realizarla.

Su capacidad depende, entre otras cosas, de:

  • cómo fue diseñada;
  • con qué datos fue entrenada;
  • cuál era su objetivo;
  • qué parámetros aprendió;
  • cómo se evaluó.


🖼️ Ejemplo: Reconocer una Imagen

Supongamos que queremos construir conceptualmente un sistema que distinga entre dos categorías de imágenes.

Durante el entrenamiento proporcionamos ejemplos etiquetados.

La red recibe una imagen y genera una predicción.

Por ejemplo:

Entrada: imagen nueva
Predicción: categoría A
Resultado correcto: categoría B

La predicción es incorrecta.

El entrenamiento utiliza esa discrepancia para contribuir al ajuste de los parámetros.

Después de numerosos ejemplos:

imágenes → predicciones → errores → ajustes

la red puede desarrollar parámetros que le permitan identificar patrones útiles para distinguir las categorías.

Lo importante es que no le entregamos necesariamente una lista explícita y completa de reglas visuales escritas por un programador.

El modelo aprende parámetros a partir de los ejemplos y del objetivo de entrenamiento.


⚠️ Pero la Red Aprende de los Datos que Recibe

Esta capacidad tiene una consecuencia fundamental.

Una red neuronal no aprende automáticamente “la verdad”.

Aprende relaciones a partir de:

  • los datos disponibles;
  • los objetivos definidos;
  • la manera en que se construyeron los ejemplos;
  • el procedimiento de entrenamiento;
  • las decisiones tomadas durante el desarrollo.

Si los datos presentan problemas, el modelo puede aprender relaciones problemáticas.

Por ejemplo, pueden existir:

  • datos insuficientes;
  • errores en las etiquetas;
  • ejemplos poco representativos;
  • información desactualizada;
  • desequilibrios entre categorías;
  • patrones espurios;
  • sesgos presentes en los datos.

Por eso, una red técnicamente sofisticada no compensa automáticamente datos deficientes.

La calidad del aprendizaje depende también de la calidad del problema, los datos y el proceso utilizado para entrenar y evaluar el modelo.


🧭 Un Error Común: “La Red Descubre Cómo Resolver Todo por Sí Misma”

Esta afirmación simplifica demasiado el proceso.

Aunque los parámetros se aprendan mediante entrenamiento, las personas siguen tomando decisiones importantes.

Entre ellas:

  • qué problema resolver;
  • qué datos utilizar;
  • qué resultado se desea obtener;
  • cómo representar los datos;
  • qué arquitectura utilizar;
  • qué criterio de error emplear;
  • cómo entrenar;
  • cómo evaluar;
  • cuándo considerar aceptable el resultado;
  • cómo implementar el sistema.

Por tanto, el aprendizaje automático no elimina el diseño humano del sistema.

Automatiza una parte del proceso de encontrar relaciones útiles a partir de datos.


🔬 Qué Ocurre Antes, Durante y Después del Entrenamiento

Podemos organizar todo el proceso en tres momentos.

Antes

Se define:

  • el problema;
  • los datos;
  • las entradas;
  • el resultado esperado;
  • la estructura del modelo;
  • la forma de evaluar su desempeño.

Durante

La red:

  • procesa ejemplos;
  • genera resultados;
  • calcula pérdidas;
  • ajusta parámetros;
  • repite el proceso.

Después

El modelo:

  • se evalúa con datos apropiados;
  • se compara con los requisitos del problema;
  • puede implementarse si cumple los criterios establecidos;
  • recibe nuevas entradas para producir resultados.

Esta visión evita pensar que entrenar una red es simplemente “darle datos y esperar”.


🧠 Entonces, ¿Dónde Está lo que la Red “Aprendió”?

Esta pregunta es especialmente importante.

En programación tradicional solemos poder señalar reglas explícitas:

SI ocurre A → HACER B

En una red neuronal, gran parte de lo aprendido queda representado en los valores de sus parámetros y en cómo esos parámetros interactúan dentro de la arquitectura.

Después del entrenamiento podemos pensar en el modelo como:

arquitectura + parámetros aprendidos

Esto conecta directamente con la Lección 10, donde estudiamos qué es un modelo de inteligencia artificial.

Una red neuronal entrenada es precisamente un ejemplo de cómo un modelo puede contener parámetros ajustados mediante aprendizaje.


💡 Experimento Mental: Cambiar los Pesos

Imagina una red ya entrenada que produce buenos resultados.

Ahora supongamos que modificamos aleatoriamente gran parte de sus pesos.

La estructura general podría seguir existiendo:

  • mismas capas;
  • mismo número de neuronas;
  • mismas conexiones.

Pero sus resultados podrían deteriorarse enormemente.

¿Por qué?

Porque una parte esencial de lo aprendido se encuentra precisamente en los valores que adquirieron esos parámetros durante el entrenamiento.

La arquitectura proporciona la estructura.

El entrenamiento determina los parámetros aprendidos.

Ambas cosas importan.


🧩 De una Neurona a una Red

Podemos ahora construir mentalmente el sistema completo:

Una neurona

Entradas → pesos → combinación → activación → salida

Varias neuronas

Entradas → conjunto de neuronas → nuevas representaciones

Varias capas

Entrada → transformaciones sucesivas → salida

Entrenamiento

Predicción → pérdida → ajuste de parámetros → repetición

Modelo entrenado

Nueva entrada → parámetros aprendidos → nueva predicción

Si comprendes esta cadena, ya tienes el mapa conceptual fundamental de una red neuronal artificial.


🏭 Caso Práctico: Detección de Defectos en una Fábrica

Imagina una fábrica que quiere identificar automáticamente determinados defectos visuales en sus productos.

Podría disponer de imágenes históricas etiquetadas, por ejemplo:

  • producto correcto;
  • producto con defecto A;
  • producto con defecto B.

El objetivo no debería comenzar con:

“Queremos utilizar redes neuronales porque son inteligencia artificial.”

Debería comenzar con el problema:

“Necesitamos detectar determinados defectos de forma suficientemente precisa y rápida para intervenir en el proceso de producción.”

A partir de ahí pueden analizarse:

  • disponibilidad y calidad de imágenes;
  • tipos de defectos;
  • frecuencia de cada defecto;
  • costo de equivocarse;
  • condiciones de iluminación;
  • velocidad necesaria;
  • recursos computacionales;
  • alternativas técnicas.

Si una red neuronal resulta adecuada, entonces se convierte en un medio para resolver el problema, no en el objetivo del proyecto.


💰 El Costo del Error También Importa

No todas las predicciones equivocadas tienen las mismas consecuencias.

Imagina dos sistemas.

Uno recomienda fotografías similares en una aplicación.

Otro ayuda a detectar una anomalía crítica en un proceso industrial.

Una equivocación puede tener consecuencias muy diferentes.

Por eso, evaluar una red neuronal no consiste únicamente en preguntar:

“¿Qué porcentaje de veces acierta?”

También debemos preguntar:

  • ¿qué tipo de errores comete?;
  • ¿qué ocurre cuando se equivoca?;
  • ¿existen errores especialmente costosos?;
  • ¿se necesita supervisión humana?;
  • ¿cuándo debería el sistema abstenerse o solicitar revisión?;
  • ¿qué nivel de desempeño exige el problema real?

Este criterio será cada vez más importante cuando avancemos desde comprender modelos hasta utilizarlos en sistemas reales.


🧪 Actividad: Sigue el Aprendizaje de una Red

Supongamos que una red debe predecir si una pieza industrial pertenece a la categoría Correcta o Defectuosa.

Recibe una pieza.

La respuesta correcta es:

Defectuosa

Pero la red predice:

Correcta

Piensa qué debería ocurrir conceptualmente a continuación.

Paso 1

La red produjo una predicción.

Paso 2

La predicción se compara con el resultado esperado.

Paso 3

Se determina una señal de error mediante el criterio de pérdida correspondiente.

Paso 4

El procedimiento de entrenamiento calcula cómo deben ajustarse determinados parámetros.

Paso 5

Los parámetros se actualizan.

Paso 6

El entrenamiento continúa con más ejemplos.

Lo importante es observar que la corrección no consiste simplemente en guardar una regla:

“Esta pieza específica es defectuosa.”

El objetivo es ajustar el modelo para que sus parámetros puedan contribuir a mejores predicciones también ante ejemplos nuevos.


🧠 Comprueba Tu Comprensión

Intenta responder antes de leer las respuestas.

1. ¿Qué es una neurona artificial?

Una unidad computacional que recibe valores, los combina utilizando parámetros y produce una salida mediante una determinada transformación.

2. ¿Qué representan los pesos?

Parámetros ajustables que influyen en cómo contribuyen diferentes conexiones al procesamiento de la información.

3. ¿Qué significa que una red neuronal aprenda?

Que durante el entrenamiento sus parámetros se modifican de acuerdo con un objetivo para mejorar su desempeño.

4. ¿Por qué necesitamos medir el error?

Porque el proceso de entrenamiento necesita una señal que indique cómo se están comportando las predicciones respecto del objetivo definido.

5. ¿Entrenar y utilizar una red son lo mismo?

No. Durante el entrenamiento se ajustan parámetros. Durante la inferencia se utiliza el modelo ya entrenado para procesar nuevas entradas.

6. ¿Una red neuronal piensa como un cerebro humano?

No. La inspiración histórica en sistemas biológicos no significa que una red neuronal artificial reproduzca el funcionamiento completo del cerebro ni que tenga comprensión humana.

7. ¿Una red neuronal siempre es la mejor herramienta?

No. La técnica debe elegirse de acuerdo con el problema, los datos, los requisitos, los costos y las alternativas disponibles.


🎯 Mini Práctica: Identifica Cada Elemento

Relaciona cada descripción con el concepto correspondiente.

A. Modifica la influencia de una conexión.
B. Mide qué tan lejos está el resultado del objetivo según un criterio.
C. Produce el resultado final de la red.
D. Proceso mediante el cual se modifican los parámetros utilizando ejemplos.
E. Uso de un modelo ya entrenado para obtener un resultado ante una nueva entrada.

Respuestas

A → Peso
B → Función de pérdida
C → Capa de salida
D → Entrenamiento
E → Inferencia

Si puedes explicar por qué corresponde cada respuesta, estás comprendiendo los conceptos en lugar de limitarte a memorizar vocabulario.


🔑 Ideas Clave de la Lección

Una red neuronal artificial:

  • recibe información de entrada;
  • procesa esa información mediante unidades conectadas;
  • utiliza pesos, sesgos y transformaciones;
  • produce una salida;
  • puede medir el error respecto de un objetivo durante el entrenamiento;
  • ajusta parámetros para intentar mejorar;
  • repite el proceso con numerosos ejemplos;
  • utiliza los parámetros aprendidos para procesar datos nuevos.

La cadena conceptual fundamental es:

Entrada → Procesamiento → Predicción → Error → Ajuste → Aprendizaje

Y una vez entrenada:

Nueva entrada → Modelo entrenado → Inferencia → Resultado


🚀 La Capacidad que Acabas de Adquirir

Después de esta lección ya no necesitas interpretar una red neuronal como una misteriosa “imitación digital del cerebro”.

Puedes verla como lo que necesitamos para trabajar con ella profesionalmente: un modelo compuesto por unidades y parámetros conectados que transforma datos de entrada en resultados y cuyos parámetros pueden ajustarse durante el entrenamiento para mejorar su desempeño respecto de un objetivo.

Esta comprensión será nuestra base para estudiar estructuras más profundas sin perder de vista qué está ocurriendo realmente.


← Lección Anterior      Índice del Programa      Siguiente Lección →

Scroll to Top