Lección 14 — Qué Es Deep Learning y Cómo Funcionan las Redes Profundas
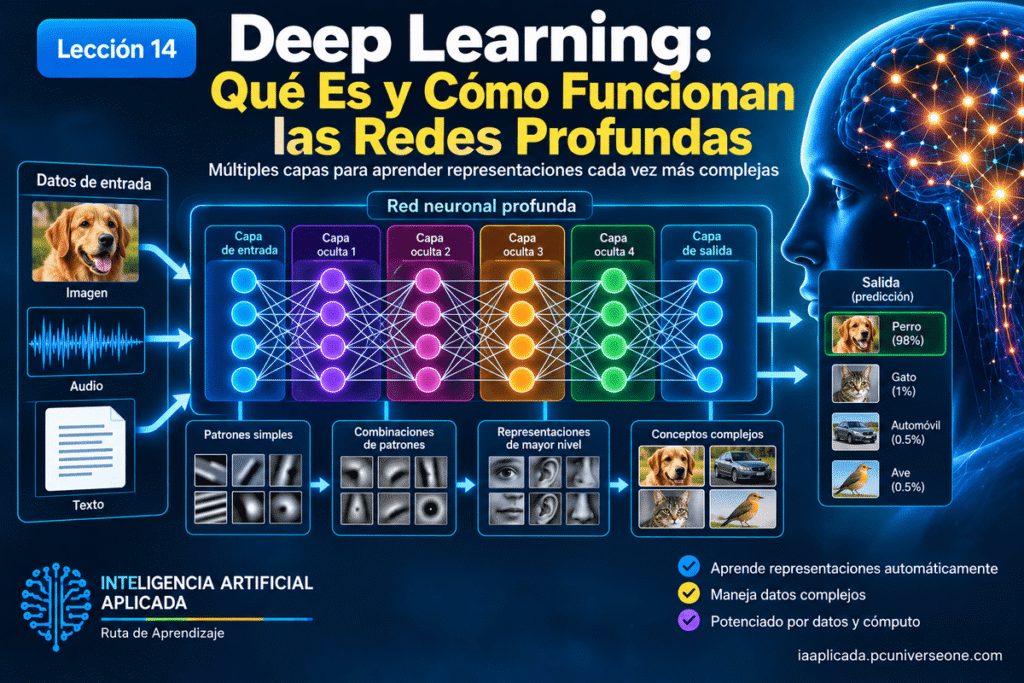
El deep learning, o aprendizaje profundo, es un enfoque de machine learning basado principalmente en redes neuronales con múltiples capas de procesamiento. Estas redes pueden aprender representaciones progresivamente más complejas a partir de los datos, lo que permite utilizarlas en problemas donde las relaciones entre la información de entrada y el resultado son difíciles de definir mediante reglas explícitas.
En la lección anterior aprendimos qué es una red neuronal artificial, qué función cumplen las neuronas, los pesos, las capas y el error, y cómo el entrenamiento modifica parámetros para mejorar los resultados. Ahora daremos el siguiente paso: comprender qué hace que una red sea “profunda”, cómo funcionan las redes neuronales profundas y por qué el deep learning se convirtió en una tecnología fundamental de la inteligencia artificial moderna.
🎯 Qué Aprenderás en Esta Lección
Al terminar esta lección podrás:
- Explicar qué es deep learning.
- Comprender qué significa que una red neuronal sea profunda.
- Diferenciar conceptualmente machine learning, redes neuronales y deep learning.
- Comprender cómo las distintas capas pueden aprender representaciones progresivamente más complejas.
- Explicar por qué el aprendizaje profundo puede trabajar eficazmente con información compleja.
- Reconocer la importancia de los datos, el cómputo y el entrenamiento.
- Comprender por qué una red más profunda no es automáticamente una red mejor.
- Identificar cuándo tiene sentido considerar deep learning y cuándo puede resultar innecesario.
La capacidad práctica que buscamos es que, cuando encuentres un sistema descrito como deep learning, puedas comprender qué significa técnicamente esa expresión y evaluar con mayor criterio si este enfoque tiene sentido para el problema.
🧩 ¿Qué Es Deep Learning?
Deep learning significa literalmente aprendizaje profundo.
Es una rama o enfoque dentro de machine learning que utiliza redes neuronales artificiales con múltiples capas de procesamiento para aprender representaciones de los datos.
Una forma sencilla de situarlo es:
Inteligencia Artificial → Machine Learning → Deep Learning
Esto no significa que todo machine learning sea deep learning.
Por ejemplo, dentro de machine learning existen numerosos métodos que no necesitan redes neuronales profundas.
Por tanto:
Todo deep learning pertenece al campo del machine learning, pero no todo machine learning es deep learning.
Esta relación es importante porque los términos suelen utilizarse indistintamente en conversaciones comerciales y medios de comunicación, aunque técnicamente no significan exactamente lo mismo.
🕸️ De una Red Neuronal al Deep Learning
En la lección anterior representamos una red neuronal de manera conceptual:
Entrada → capa oculta → salida
También vimos que puede haber más de una capa oculta:
Entrada → capa oculta 1 → capa oculta 2 → salida
Cuando trabajamos con arquitecturas que contienen múltiples capas capaces de aprender representaciones sucesivas de los datos, entramos en el terreno de las redes neuronales profundas y el deep learning.
Podemos visualizarlo así:
Datos → capa 1 → capa 2 → capa 3 → … → salida
La palabra “profundo” hace referencia precisamente a esta profundidad de procesamiento.
No significa que la máquina piense de manera “más profunda” que una persona.
Se refiere fundamentalmente a la estructura de la red y a las sucesivas transformaciones que ocurren a través de sus capas.
⚠️ “Profundo” No Significa Inteligente como una Persona
Esta distinción merece especial atención.
Cuando escuchamos expresiones como:
- aprendizaje profundo;
- redes neuronales;
- neuronas artificiales;
- aprendizaje;
- atención;
- memoria;
es fácil interpretar esos términos utilizando su significado humano.
Pero en inteligencia artificial suelen describir mecanismos matemáticos y computacionales específicos.
Una red profunda puede contener millones o incluso muchos más parámetros y realizar transformaciones extremadamente complejas sin que eso implique que posea:
- conciencia;
- comprensión humana;
- razonamiento humano general;
- experiencias;
- intenciones.
El término deep learning describe un enfoque técnico, no una afirmación acerca de la profundidad intelectual de una máquina.
🧱 ¿Qué Hace Cada Capa?
Aquí aparece una de las ideas más importantes de esta lección.
Las capas de una red profunda pueden aprender representaciones internas que transforman progresivamente la información.
Pensemos conceptualmente en una imagen.
La entrada original está formada por información numérica que representa la imagen.
A medida que esa información atraviesa las capas, la red puede desarrollar representaciones internas útiles para realizar la tarea para la que fue entrenada.
De manera muy simplificada podríamos imaginar:
Datos visuales → patrones simples → combinaciones de patrones → representaciones más complejas → resultado
La idea importante no es que podamos asignar siempre una interpretación humana perfecta a cada neurona o capa.
Lo importante es que las capas permiten realizar transformaciones sucesivas.
Cada transformación trabaja sobre la representación producida anteriormente.
🪜 Una Forma de Entender la Profundidad
Imagina que necesitas realizar una tarea compleja.
En lugar de intentar resolverla mediante una sola transformación gigantesca, puedes dividir el procesamiento en etapas.
Conceptualmente:
Información original
↓
Primera representación
↓
Representación transformada
↓
Representación de mayor nivel
↓
Resultado
Las redes profundas hacen algo conceptualmente relacionado: encadenan numerosas transformaciones aprendidas.
Esto permite construir relaciones complejas mediante la combinación de operaciones más pequeñas.
Pero debemos introducir inmediatamente una precisión:
No debemos imaginar que cada capa necesariamente corresponde a un concepto humano perfectamente identificable.
En algunos casos podemos analizar qué patrones parecen activar determinadas partes de una red. En otros, las representaciones internas están distribuidas entre numerosos parámetros y son mucho más difíciles de interpretar.
🔍 ¿Qué Significa “Aprender Representaciones”?
Supongamos que queremos trabajar con imágenes.
Una computadora no recibe inicialmente conceptos como:
“oreja”, “rueda”, “ventana”, “rostro” o “automóvil”.
Recibe datos numéricos.
El entrenamiento puede permitir que una red construya internamente representaciones útiles para diferenciar los patrones relevantes para su objetivo.
Esto es lo que queremos decir cuando hablamos de aprendizaje de representaciones.
En enfoques tradicionales de machine learning, una persona puede necesitar diseñar manualmente muchas de las características que utilizará el modelo.
Con deep learning, parte de esa representación puede aprenderse automáticamente a partir de los datos durante el entrenamiento.
Esta capacidad constituye una de las razones fundamentales de su importancia.
🛠️ Características Diseñadas vs. Características Aprendidas
Imagina que queremos clasificar determinados objetos.
En un enfoque más tradicional podríamos diseñar manualmente características como:
- tamaño;
- forma;
- textura;
- determinados valores estadísticos;
- relaciones entre medidas.
Posteriormente un modelo utilizaría esas características para realizar la predicción.
Conceptualmente:
Datos → características diseñadas por personas → modelo → resultado
Con deep learning podemos encontrar un enfoque diferente:
Datos → representaciones aprendidas por la red → resultado
Esto no significa que desaparezca la intervención humana.
Las personas siguen tomando decisiones sobre:
- qué problema resolver;
- qué datos utilizar;
- cómo preparar esos datos;
- qué arquitectura emplear;
- cómo entrenar;
- cómo evaluar;
- qué métricas utilizar;
- qué riesgos aceptar;
- cómo implementar el sistema.
Lo que cambia es que parte de la construcción de representaciones útiles puede aprenderse durante el entrenamiento.
⚙️ ¿Cómo Aprende una Red Neuronal Profunda?
El principio fundamental es el mismo que estudiamos en la Lección 13.
La red:
- Recibe datos.
- Realiza transformaciones a través de sus capas.
- Produce una salida.
- Compara esa salida con el objetivo correspondiente durante el entrenamiento.
- Calcula una pérdida.
- Determina cómo modificar sus parámetros.
- Actualiza los parámetros.
- Repite el proceso.
Podemos resumirlo:
Entrada → capas → predicción → pérdida → ajuste → repetición
La diferencia es que una red profunda puede contener muchísimas capas, conexiones y parámetros, por lo que el aprendizaje implica coordinar una gran cantidad de valores.
No aparece una forma completamente distinta de “aprender” solo porque añadamos profundidad.
Seguimos hablando fundamentalmente de optimización de parámetros a partir de un objetivo de entrenamiento.
↩️ La Retropropagación Sigue Siendo Fundamental
En la lección anterior presentamos la retropropagación, o backpropagation.
En una red profunda, necesitamos calcular cómo los parámetros distribuidos a través de numerosas capas contribuyen al resultado y a la pérdida.
La retropropagación permite calcular eficientemente la información necesaria para determinar cómo debería cambiar cada parámetro.
Conceptualmente:
Predicción → cálculo de pérdida → propagación de información para calcular gradientes → actualización de parámetros
El procedimiento matemático real es más preciso que la expresión informal “el error viaja hacia atrás”.
Lo importante para nuestro nivel de aplicación es comprender su función:
Permitir que el entrenamiento determine cómo ajustar parámetros distribuidos a través de las distintas capas de una red.
📉 ¿Por Qué Entrenar Redes Profundas Puede Ser Difícil?
Añadir profundidad aumenta la capacidad potencial del modelo, pero también puede complicar el entrenamiento.
Pueden aparecer dificultades relacionadas con:
- cantidad y calidad de datos;
- costo computacional;
- tiempo de entrenamiento;
- selección de arquitectura;
- ajuste de hiperparámetros;
- estabilidad del entrenamiento;
- capacidad de generalización;
- consumo de memoria;
- interpretación de resultados.
Además, una red con enorme capacidad puede aprender relaciones que funcionan muy bien en los datos utilizados durante el entrenamiento y no generalizar suficientemente bien a situaciones nuevas.
Por tanto:
Mayor capacidad ≠ mejor solución garantizada
La arquitectura debe responder al problema.
💻 El hardware debe responder al trabajo que necesitas realizar
Trabajar con modelos de inteligencia artificial puede exigir diferentes niveles de procesador, memoria, almacenamiento o aceleración gráfica. No todos los proyectos necesitan una estación de trabajo de alto rendimiento.
Define primero qué modelos y tareas necesitas ejecutar y después dimensiona el equipo adecuado.
Consultar opciones de tecnología en PCUniverseOne →
💻 Por Qué el Cómputo Fue Tan Importante para el Deep Learning
Entrenar redes neuronales profundas puede requerir realizar enormes cantidades de operaciones matemáticas.
El desarrollo de hardware capaz de ejecutar muchas operaciones en paralelo contribuyó significativamente al crecimiento del deep learning.
Las GPU, originalmente muy asociadas al procesamiento gráfico, resultaron especialmente útiles para numerosos cálculos utilizados durante el entrenamiento de redes neuronales.
Posteriormente se desarrollaron también otros aceleradores especializados para cargas de inteligencia artificial.
Esto nos deja una enseñanza importante:
El progreso de la IA no depende únicamente de nuevas ideas algorítmicas.
También depende de la interacción entre:
algoritmos + datos + capacidad computacional + infraestructura
Cuando alguno de estos elementos cambia considerablemente, pueden hacerse viables soluciones que anteriormente resultaban demasiado lentas, costosas o difíciles de entrenar.
📚 Los Datos También Cambiaron el Panorama
La capacidad computacional por sí sola no explica el desarrollo moderno del deep learning.
Muchas redes necesitan grandes cantidades de ejemplos para aprender relaciones útiles.
El crecimiento de:
- colecciones digitales;
- imágenes;
- texto;
- audio;
- video;
- sensores;
- registros de actividad;
- fuentes de información en línea;
hizo posible disponer de volúmenes de datos que anteriormente eran difíciles de reunir.
Sin embargo, más datos tampoco significa automáticamente mejores datos.
Importan también:
- calidad;
- representatividad;
- diversidad;
- relevancia;
- etiquetado cuando sea necesario;
- procedencia;
- permisos de utilización;
- privacidad;
- posibles sesgos.
Una red profunda entrenada con enormes cantidades de información deficiente puede seguir produciendo resultados deficientes.
📊 Machine Learning vs. Deep Learning
La búsqueda machine learning vs deep learning es frecuente porque ambos conceptos están estrechamente relacionados, pero no son equivalentes.
Podemos compararlos conceptualmente:
| Aspecto | Machine Learning | Deep Learning |
|---|---|---|
| Alcance | Campo amplio de aprendizaje automático | Enfoque dentro de machine learning |
| Modelos | Incluye muchas familias de modelos | Utiliza principalmente redes neuronales profundas |
| Características | Pueden diseñarse manualmente en muchos enfoques | Puede aprender representaciones automáticamente |
| Datos | Algunos métodos funcionan bien con conjuntos relativamente modestos | Muchos sistemas profundos se benefician de grandes cantidades de datos |
| Cómputo | Puede requerir recursos relativamente moderados | El entrenamiento puede ser computacionalmente intensivo |
| Interpretabilidad | Algunos modelos son relativamente fáciles de interpretar | Las redes profundas pueden ser difíciles de interpretar |
| Datos complejos | Puede trabajar con numerosos tipos de datos | Ha resultado especialmente importante en datos complejos como imágenes, audio y lenguaje |
Pero debemos evitar convertir esta tabla en una competencia.
No existe una regla profesional como:
Deep learning > machine learning tradicional
La pregunta correcta es:
¿Qué enfoque resuelve mejor este problema bajo nuestras condiciones reales?
🧮 Un Problema Sencillo No Necesita una Solución Profunda
Imagina una empresa con un conjunto pequeño de datos tabulares y un problema de predicción relativamente sencillo.
Podría resultar posible resolverlo satisfactoriamente mediante un modelo tradicional que:
- entrene rápidamente;
- necesite menos recursos;
- sea más fácil de explicar;
- tenga un desempeño adecuado.
Utilizar una enorme red profunda únicamente porque es una tecnología más sofisticada podría añadir:
- costo;
- complejidad;
- infraestructura;
- mantenimiento;
- dificultad de interpretación;
sin aportar una mejora que justifique esos inconvenientes.
Este principio aparecerá repetidamente durante el programa:
La solución técnicamente más compleja no es necesariamente la solución profesionalmente más adecuada.
🧠 Entonces, ¿Cuándo Resulta Especialmente Interesante el Deep Learning?
El deep learning resulta especialmente relevante cuando necesitamos aprender relaciones complejas a partir de grandes cantidades de información y cuando las representaciones útiles no son fáciles de definir manualmente.
Puede resultar especialmente valioso al trabajar con:
- imágenes;
- lenguaje;
- audio;
- voz;
- video;
- señales complejas;
- grandes volúmenes de datos;
- combinaciones de diferentes tipos de información.
Esto no significa que siempre sea necesario en esos dominios.
Significa que las redes profundas han demostrado ser herramientas muy importantes para muchos problemas de este tipo.
En la siguiente lección estudiaremos precisamente cómo se aplica deep learning a diferentes clases de problemas, por lo que aquí mantendremos nuestra atención en sus fundamentos.
🏭 Caso Práctico: Inspección Visual de Productos
Supongamos que una fábrica necesita identificar defectos en piezas mediante fotografías.
Tenemos:
Entrada: imagen de una pieza.
Objetivo: determinar si presenta determinados defectos.
Una estrategia tradicional podría requerir que especialistas definieran manualmente características visuales relevantes.
Por ejemplo:
- bordes;
- formas;
- texturas;
- dimensiones;
- variaciones de color.
Después, esas características podrían proporcionarse a un modelo.
Un enfoque basado en deep learning podría permitir que una red aprenda durante el entrenamiento representaciones visuales útiles directamente a partir de los datos.
Pero antes de decidir que necesitamos deep learning debemos preguntar:
- ¿tenemos suficientes imágenes?
- ¿los defectos están correctamente identificados?
- ¿las imágenes representan las condiciones reales de producción?
- ¿qué errores son aceptables?
- ¿qué ocurre con defectos nunca vistos?
- ¿qué velocidad necesita la línea?
- ¿dónde se ejecutará el modelo?
- ¿qué hardware estará disponible?
- ¿existe una alternativa más sencilla?
La tecnología se selecciona después de comprender el problema.
🧪 El Mismo Problema Puede Tener Diferentes Soluciones
Supongamos que queremos detectar si una máquina industrial funciona normalmente.
Podríamos disponer de:
- temperatura;
- vibración;
- presión;
- consumo eléctrico;
- velocidad;
- registros históricos.
Una opción podría utilizar métodos estadísticos.
Otra podría utilizar algoritmos tradicionales de machine learning.
Otra podría utilizar una red neuronal.
Otra podría utilizar deep learning.
Incluso podría ser apropiado combinar varios métodos.
La existencia de deep learning no elimina las demás herramientas.
Amplía nuestro conjunto de posibilidades.
🚫 Error Común: “Si Tengo Más Capas, Tendré Más Inteligencia”
No.
Una red más grande o profunda puede tener mayor capacidad para representar relaciones complejas, pero también puede:
- requerir más datos;
- consumir más recursos;
- tardar más en entrenar;
- resultar más difícil de ajustar;
- sobreajustarse;
- ser innecesariamente compleja;
- dificultar su interpretación;
- incrementar costos de operación.
El objetivo profesional no es construir la red más grande.
Es resolver el problema con el nivel de desempeño, costo, seguridad y confiabilidad que la situación exige.
📦 Modelo Entrenado vs. Entrenar Desde Cero
Esta distinción es particularmente importante para quien aprende inteligencia artificial aplicada.
Comprender deep learning no significa que debas entrenar una enorme red neuronal desde cero cada vez que necesites utilizar IA.
En muchos proyectos puedes trabajar con:
- modelos previamente entrenados;
- servicios de inteligencia artificial;
- APIs;
- modelos especializados;
- plataformas que incorporan deep learning;
- modelos que pueden adaptarse a una tarea específica.
Esto cambia radicalmente la barrera de entrada.
Un equipo puede aprovechar sistemas construidos mediante deep learning sin poseer la infraestructura necesaria para realizar todo el entrenamiento original.
Por eso necesitamos diferenciar dos capacidades:
Comprender cómo se construye y entrena un modelo
y
saber utilizar profesionalmente modelos existentes para resolver problemas.
Ambas son valiosas, pero no son lo mismo.
🔬 ¿Qué Hay Dentro de un Modelo Profundo Entrenado?
Recordemos una idea de la lección anterior.
Podemos pensar conceptualmente en un modelo neuronal entrenado como:
arquitectura + parámetros aprendidos
En una red profunda, esos parámetros pueden distribuirse a través de numerosas capas.
Durante el entrenamiento se modifican para construir transformaciones útiles para el objetivo.
Cuando utilizamos posteriormente el modelo:
Nueva entrada → transformaciones aprendidas → salida
Normalmente ya no estamos modificando todos esos parámetros en cada consulta.
Estamos realizando inferencia utilizando lo aprendido previamente.
🔄 Entrenamiento e Inferencia en Deep Learning
Conviene consolidar esta diferencia.
Durante el entrenamiento
La red:
- recibe ejemplos;
- realiza predicciones;
- calcula pérdidas;
- obtiene información para ajustar parámetros;
- actualiza parámetros;
- repite el proceso.
Durante la inferencia
La red:
- recibe una entrada nueva;
- utiliza sus parámetros aprendidos;
- realiza las transformaciones correspondientes;
- produce un resultado.
Conceptualmente:
ENTRENAMIENTO
Datos → Red → Predicción → Error → Ajuste → Repetición
INFERENCIA
Dato nuevo → Red entrenada → Resultado
Confundir ambos procesos puede llevar a errores al evaluar costos, infraestructura y funcionamiento de un sistema de IA.
💰 Entrenar y Utilizar Pueden Tener Costos Muy Diferentes
Una red profunda puede requerir grandes recursos durante su entrenamiento y recursos muy diferentes cuando se utiliza posteriormente.
Por ejemplo, un modelo podría entrenarse utilizando infraestructura especializada y después ejecutarse en:
- servidores;
- servicios en la nube;
- computadoras;
- teléfonos;
- dispositivos especializados;
- sistemas integrados;
dependiendo de su tamaño, optimización y requisitos.
Por eso, al evaluar una solución debemos separar preguntas como:
¿Cuánto cuesta entrenar el modelo?
de:
¿Cuánto cuesta ejecutar una predicción?
y también:
¿Dónde necesita funcionar?
Estas preguntas son distintas y pueden cambiar completamente la arquitectura de una solución.
⚖️ Capacidad, Costo y Necesidad
Podemos imaginar la selección de tecnología como un equilibrio:
Capacidad necesaria ↔ datos disponibles ↔ costo ↔ velocidad ↔ interpretabilidad ↔ infraestructura
Una red profunda podría ofrecer un excelente desempeño, pero si:
- no tenemos suficientes datos;
- no podemos asumir el costo;
- necesitamos una explicación muy transparente;
- la latencia es inaceptable;
- un método sencillo ya resuelve suficientemente el problema;
entonces quizá no sea la opción adecuada.
La inteligencia artificial aplicada exige aprender no solamente qué puede hacerse, sino también qué conviene hacer.
🧪 Actividad: ¿Necesitamos Deep Learning?
Analiza los siguientes escenarios.
Caso A
Una pequeña empresa quiere predecir una variable a partir de seis columnas numéricas y dispone de unos pocos miles de registros.
¿Necesita obligatoriamente deep learning?
No.
Podrían existir modelos mucho más sencillos capaces de resolver adecuadamente el problema. Habría que comparar alternativas.
Caso B
Una organización necesita analizar grandes cantidades de imágenes y reconocer patrones visuales difíciles de describir mediante reglas manuales.
¿Podría ser relevante deep learning?
Sí.
Es un escenario en el que las redes profundas pueden resultar especialmente útiles, aunque todavía habría que analizar datos, requisitos y alternativas.
Caso C
Una empresa dispone de un modelo previamente entrenado que ya resuelve gran parte de su problema.
¿Debe entrenar otro desde cero?
No necesariamente.
Puede resultar mucho más eficiente aprovechar o adaptar un modelo existente.
La decisión depende del problema, no del deseo de utilizar la tecnología más sofisticada.
🔎 Cinco Preguntas Antes de Elegir Deep Learning
Antes de decidir utilizar una red neuronal profunda, pregúntate:
- ¿Qué problema estoy intentando resolver?
- ¿Qué datos tengo y qué calidad poseen?
- ¿Existe una solución más sencilla que alcance el desempeño necesario?
- ¿Dispongo de los recursos necesarios para entrenar o ejecutar la solución?
- ¿Cómo comprobaré que realmente funciona ante datos nuevos?
Observa que ninguna pregunta empieza con:
“¿Qué red neuronal está de moda?”
Ese cambio de perspectiva es fundamental.
🧠 Comprueba Tu Comprensión
Intenta responder antes de leer las respuestas.
1. ¿Qué es deep learning?
Un enfoque de machine learning basado principalmente en redes neuronales profundas capaces de aprender representaciones mediante múltiples capas de procesamiento.
2. ¿Por qué se denomina “profundo”?
Por la existencia de múltiples capas de transformación dentro de la red, no porque la máquina tenga pensamiento profundo.
3. ¿Deep learning y machine learning son sinónimos?
No. Deep learning forma parte del campo más amplio de machine learning.
4. ¿Qué significa aprender representaciones?
Que el modelo desarrolla internamente transformaciones de los datos que resultan útiles para realizar la tarea para la que se entrena.
5. ¿Más capas garantizan mejores resultados?
No. Una mayor profundidad también puede aumentar requisitos, complejidad y dificultades de entrenamiento.
6. ¿Necesitamos entrenar siempre una red profunda desde cero?
No. En muchas aplicaciones pueden utilizarse modelos previamente entrenados, servicios, APIs u otras herramientas existentes.
7. ¿Cuál debe ser el punto de partida para elegir deep learning?
El problema que necesitamos resolver y sus requisitos, no la tecnología.
🎯 Mini Práctica: Machine Learning o Deep Learning
Clasifica cada afirmación.
A. Campo amplio que incluye diferentes familias de algoritmos de aprendizaje.
B. Enfoque que utiliza redes neuronales profundas.
C. Puede incluir modelos relativamente sencillos que funcionan muy bien con datos tabulares.
D. Puede aprender representaciones complejas mediante múltiples capas.
Respuestas
A → Machine Learning
B → Deep Learning
C → Machine Learning
D → Deep Learning
Ahora añade una quinta afirmación:
E. Siempre es mejor utilizarlo cuando existe suficiente capacidad computacional.
La respuesta es:
Ninguno.
Esa afirmación es incorrecta porque la elección depende del problema y de los requisitos, no únicamente de la disponibilidad de cómputo.
🔑 Ideas Clave de la Lección
El deep learning:
- forma parte de machine learning;
- utiliza principalmente redes neuronales profundas;
- realiza múltiples transformaciones sucesivas de los datos;
- puede aprender representaciones útiles durante el entrenamiento;
- puede trabajar eficazmente con información compleja;
- suele beneficiarse de datos y capacidad computacional significativos;
- puede resultar costoso y difícil de entrenar;
- no siempre es superior a métodos más sencillos;
- puede aprovecharse mediante modelos previamente entrenados sin entrenarlos desde cero.
La cadena conceptual fundamental es:
Datos → Capas → Representaciones → Predicción → Error → Ajuste
Y, después del entrenamiento:
Dato nuevo → Red profunda entrenada → Inferencia → Resultado
🚀 La Capacidad que Acabas de Adquirir
Después de esta lección ya puedes interpretar deep learning sin reducirlo a la idea vaga de una “IA más avanzada”.
Puedes reconocerlo como un enfoque de machine learning basado en redes neuronales profundas que aprenden transformaciones y representaciones mediante múltiples capas.
Más importante todavía: ya puedes formular la pregunta profesional adecuada.
No:
“¿Podemos utilizar deep learning?”
Sino:
“¿El problema justifica utilizar deep learning frente a otras alternativas?”
Ese criterio será esencial cuando pasemos de comprender la tecnología a analizar dónde puede aplicarse realmente.