Lección 10 — Qué Es un Modelo de Inteligencia Artificial: Cómo se Entrena y Cómo se Utiliza
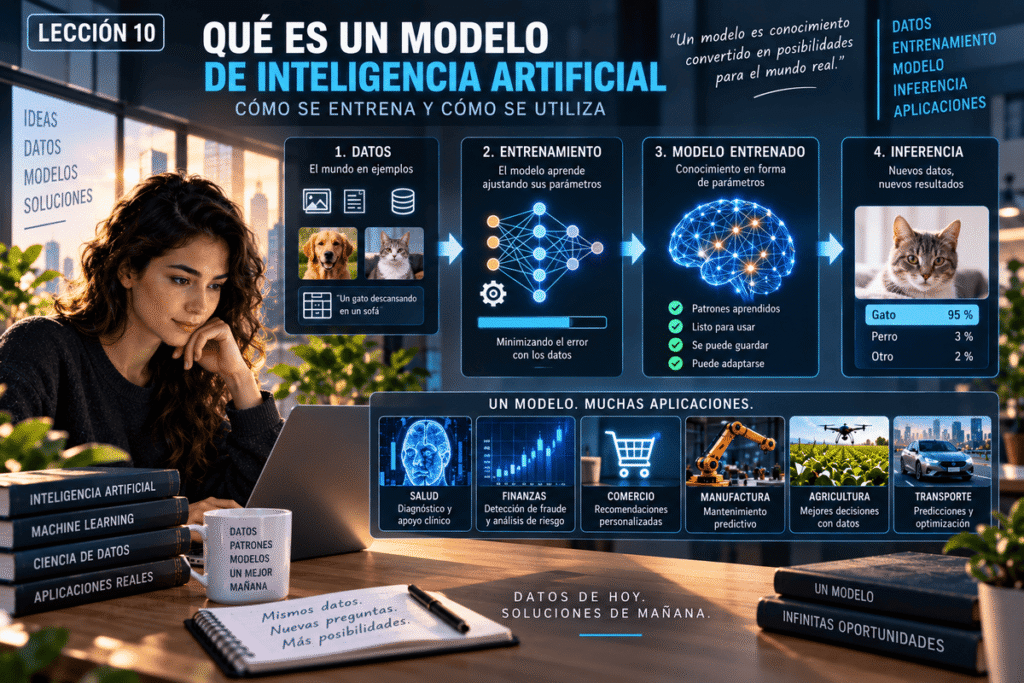
Un modelo de inteligencia artificial es una representación aprendida o ajustada mediante un proceso de entrenamiento para realizar una tarea determinada a partir de datos. Cuando utilizamos un modelo ya entrenado, no necesitamos repetir necesariamente todo ese entrenamiento: proporcionamos información nueva al modelo para obtener una predicción, clasificación, recomendación, generación u otro resultado.
En la lección anterior estudiamos cómo una IA puede aprender patrones a partir de datos. Ahora centraremos nuestra atención en qué obtenemos como resultado de ese proceso: el modelo, y aprenderemos a distinguirlo de los datos, del algoritmo utilizado para entrenarlo y de la aplicación que finalmente lo utiliza.
La diferencia es fundamental:
Datos ≠ Algoritmo de entrenamiento ≠ Modelo entrenado ≠ Aplicación final
Comprender estas cuatro piezas nos permitirá hablar de inteligencia artificial con mucha mayor precisión y, sobre todo, entender qué estamos utilizando cuando trabajamos con modelos ya existentes.
🎯 Qué Aprenderás en Esta Lección
Al finalizar esta lección podrás:
- explicar qué es un modelo de inteligencia artificial;
- distinguir un modelo de los datos utilizados para entrenarlo;
- diferenciar un algoritmo o proceso de entrenamiento de un modelo entrenado;
- comprender conceptualmente qué contienen los parámetros de un modelo;
- explicar cómo se obtiene un modelo mediante entrenamiento;
- distinguir entrenamiento de inferencia;
- reconocer diferentes tipos de resultados producidos por modelos;
- comprender que una aplicación de IA puede utilizar uno o varios modelos;
- reconocer que el modelo es solamente una parte de una solución completa;
- identificar qué necesitamos conocer antes de seleccionar un modelo para un problema real.
La capacidad práctica que buscamos desarrollar es:
identificar qué papel desempeña un modelo dentro de una solución de IA y distinguir claramente entre construir o entrenar un modelo y utilizar uno que ya está entrenado.
🧩 ¿Qué Es Exactamente un Modelo?
Pensemos nuevamente en nuestro ejemplo de clasificación de imágenes.
Disponemos de miles de fotografías identificadas como:
- perro;
- gato.
Utilizamos esos datos durante un proceso de entrenamiento.
El sistema ajusta valores internos intentando encontrar relaciones que le permitan distinguir ambas categorías.
Al finalizar obtenemos algo que puede recibir una fotografía nueva y producir un resultado como:
Perro: 96 %
Gato: 4 %
Esa pieza que utilizamos para transformar una entrada nueva en un resultado es el modelo entrenado.
Podemos representarlo así:
Entrada nueva → Modelo → Resultado
El modelo no es simplemente la colección original de fotografías.
Tampoco es toda la aplicación.
Es una pieza computacional que contiene relaciones aprendidas durante el entrenamiento y que puede utilizarse posteriormente para realizar la tarea para la que fue desarrollado.
🧠 Una Forma Intuitiva de Pensar en un Modelo
Imaginemos que observamos muchos ejemplos de viviendas junto con sus precios.
A partir de ellos encontramos relaciones entre:
- superficie;
- ubicación;
- antigüedad;
- número de habitaciones;
- otras características;
y el precio observado.
El modelo representa, de alguna manera matemática, relaciones aprendidas entre las entradas y el resultado que queremos obtener.
Después podemos proporcionar:
una vivienda nueva
y obtener:
un precio estimado.
Esto nos proporciona una definición práctica:
Un modelo es una representación computacional de patrones o relaciones aprendidos que puede utilizarse para producir resultados ante nuevas entradas.
La forma exacta de esa representación depende enormemente del tipo de modelo.
Algunos pueden ser relativamente sencillos.
Otros pueden contener millones o miles de millones de parámetros.
Pero la idea fundamental continúa siendo la misma:
el modelo conserva lo aprendido de una manera que puede utilizarse posteriormente.
🗂️ El Modelo No Es lo Mismo que los Datos
Ésta es una confusión frecuente.
Supongamos que entrenamos un sistema con un millón de fotografías.
Tenemos:
Datos de entrenamiento = fotografías y otra información asociada
Después del entrenamiento obtenemos:
Modelo = parámetros y estructura utilizados para realizar la tarea aprendida
No son lo mismo.
Podemos representarlo así:
Datos → Proceso de entrenamiento → Modelo
Una vez obtenido el modelo, podemos utilizarlo con una fotografía nueva:
Fotografía nueva → Modelo → Predicción
Esto no significa que los datos originales dejen de ser importantes.
Son fundamentales porque influyeron en lo que el modelo pudo aprender.
Pero debemos distinguir:
los ejemplos utilizados para aprender
de
la representación resultante que utilizamos después.
⚙️ Algoritmo y Modelo Tampoco Son lo Mismo
Existe otra distinción fundamental.
Un algoritmo de aprendizaje define un procedimiento utilizado para ajustar un modelo.
El modelo entrenado es el resultado obtenido después de aplicar ese proceso utilizando determinados datos y configuraciones.
Una analogía sencilla puede ayudarnos.
Imagina una receta.
Receta → procedimiento
Ingredientes → datos disponibles
Preparación → proceso
Platillo terminado → resultado
La analogía tiene límites, pero permite ver que:
procedimiento y resultado no son la misma cosa.
En machine learning ocurre algo parecido:
Algoritmo + Datos + Entrenamiento → Modelo entrenado
Dos modelos pueden utilizar enfoques similares y terminar siendo diferentes porque fueron entrenados:
- con distintos datos;
- con diferentes configuraciones;
- durante diferentes procesos;
- para distintas tareas.
🔢 ¿Qué Contiene un Modelo?
En muchos modelos de machine learning encontramos parámetros.
Los parámetros son valores internos que se ajustan durante el entrenamiento.
Podemos pensar en ellos como números que ayudan a determinar cómo transforma el modelo una entrada en un resultado.
Imaginemos un modelo extremadamente sencillo que intenta estimar el precio de una vivienda utilizando únicamente su superficie.
Podría aprender una relación simplificada como:
Precio estimado = superficie × valor aprendido + ajuste
Los valores utilizados en esa relación serían parámetros del modelo.
Los modelos modernos pueden ser incomparablemente más complejos.
Una red neuronal puede contener:
- miles;
- millones;
- miles de millones;
de parámetros relacionados entre sí.
No necesitamos inspeccionarlos individualmente para utilizar el modelo.
Lo importante por ahora es comprender:
durante el entrenamiento se ajustan parámetros; esos parámetros forman parte de lo que el modelo ha aprendido.
🏋️ ¿Cómo se Entrena un Modelo de Inteligencia Artificial?
En la Lección 9 estudiamos el proceso de aprendizaje.
Ahora podemos relacionarlo directamente con el modelo.
De manera simplificada:
1. Tenemos datos.
2. Inicializamos o partimos de un modelo.
3. El modelo produce resultados.
4. Comparamos esos resultados con algún criterio de evaluación durante el entrenamiento.
5. Medimos el error o señal correspondiente.
6. Ajustamos parámetros.
7. Repetimos el proceso.
El objetivo es obtener un modelo cuyos parámetros permitan realizar adecuadamente la tarea definida.
Podemos representarlo:
Datos
↓
Modelo
↓
Predicción
↓
Evaluación/Error
↓
Ajuste de parámetros
↺
Después de suficientes iteraciones y de acuerdo con los criterios establecidos:
Modelo entrenado
La implementación concreta puede variar enormemente según el tipo de aprendizaje y modelo.
Por ahora nos interesa la estructura conceptual.
🔁 Entrenar un Modelo No Significa Crearlo Siempre Desde Cero
Ésta es una idea especialmente importante para un programa de Inteligencia Artificial Aplicada.
Podemos utilizar IA profesionalmente sin entrenar todos los modelos desde cero.
Existen diferentes posibilidades.
Construir y entrenar un modelo para una tarea
Disponemos de datos y realizamos un proceso de entrenamiento específico.
Partir de un modelo previamente entrenado
Podemos aprovechar capacidades que el modelo ya posee y adaptarlo cuando resulte apropiado.
Utilizar directamente un modelo existente
Muchas aplicaciones consumen modelos disponibles mediante:
- servicios;
- plataformas;
- bibliotecas;
- APIs;
- aplicaciones especializadas.
Esto cambia radicalmente la pregunta práctica.
No siempre debemos preguntar:
“¿Cómo construyo mi propio modelo?”
También debemos preguntar:
“¿Existe ya un modelo apropiado que pueda utilizar o adaptar para resolver este problema?”
Ésta será una decisión recurrente durante todo el programa.
🚀 Entrenamiento vs. Inferencia
Llegamos ahora a una distinción que debemos dominar.
🏋️ Entrenamiento
Durante el entrenamiento:
Datos → Proceso de aprendizaje → Ajuste de parámetros → Modelo
El objetivo es obtener o ajustar el modelo.
⚡ Inferencia
Durante la inferencia:
Dato nuevo → Modelo entrenado → Resultado
El objetivo es utilizar lo aprendido.
Por ejemplo:
Entrenamiento
Miles de imágenes de productos ayudan a ajustar un modelo para reconocer defectos.
Inferencia
Una cámara captura un producto nuevo.
La imagen se envía al modelo.
El modelo responde:
Posible defecto: 87 %
Después el sistema decide qué hacer con ese resultado.
La diferencia puede resumirse así:
Entrenar es ajustar lo que el modelo ha aprendido. Inferir es utilizar ese aprendizaje ante una entrada.
📥 Entrada → Modelo → Salida
Una vez entrenado, podemos pensar en un modelo como una función que recibe información y produce un resultado.
Clasificación
Imagen → Modelo → “Perro”
Predicción numérica
Características de vivienda → Modelo → Precio estimado
Recomendación
Información disponible → Modelo → Elementos relevantes
Procesamiento de lenguaje
Texto → Modelo → Categoría / resumen / respuesta
Generación de imágenes
Instrucción → Modelo → Imagen generada
Aunque los modelos y procesos internos sean muy diferentes, encontramos una estructura común:
Entrada → Modelo → Salida
Esta estructura sencilla nos ayudará a analizar sistemas mucho más complejos posteriormente.
⚠️ La Salida del Modelo No Es Necesariamente la Decisión Final
Supongamos que un modelo analiza una transacción y produce:
Riesgo estimado: alto
¿Qué debe ocurrir después?
Una posibilidad sería bloquear automáticamente la operación.
Otra sería:
enviarla a revisión.
Otra:
solicitar una verificación adicional.
El modelo produce un resultado.
Pero cómo utilizamos ese resultado es una decisión de diseño del sistema.
Podemos representar la solución completa:
Datos → Modelo → Resultado → Regla/Proceso → Acción
Y en determinados contextos:
Datos → Modelo → Resultado → Persona → Decisión
Esta distinción es especialmente importante cuando los errores pueden tener consecuencias relevantes.
🧱 Un Modelo No Es Toda la Aplicación
Imagina una aplicación que permite subir una fotografía y saber qué objeto aparece.
La aplicación puede necesitar:
- interfaz;
- autenticación;
- almacenamiento;
- procesamiento de archivos;
- modelo de visión;
- programación;
- bases de datos;
- controles de seguridad;
- registro de resultados;
- infraestructura.
El modelo realiza una función dentro del sistema.
Por eso:
Aplicación de IA ≠ Modelo de IA
Una aplicación puede utilizar:
- un modelo;
- varios modelos;
- reglas;
- automatizaciones;
- servicios externos;
- intervención humana.
Esta distinción será fundamental cuando comencemos a construir soluciones reales con IA.
💻 El modelo es una pieza; tu proyecto necesita una solución completa
Trabajar con inteligencia artificial no siempre significa entrenar grandes modelos desde cero. Muchas soluciones pueden construirse integrando modelos existentes con software, datos y los recursos tecnológicos adecuados.
Conforme tus proyectos requieran ejecutar modelos localmente, procesar mayores volúmenes de información o integrar nuevas capacidades, podrás evaluar qué equipo necesita realmente cada solución.
Explora opciones para tus proyectos tecnológicos →
🔗 Una Aplicación Puede Utilizar Varios Modelos
Imaginemos un asistente que recibe una pregunta mediante voz y responde también hablando.
Podrían intervenir diferentes componentes:
1. Audio → Texto
Un modelo procesa la voz.
2. Texto → Interpretación/Respuesta
Otro modelo trabaja con lenguaje.
3. Texto → Audio
Otro componente genera la voz.
Además pueden existir:
- reglas;
- búsquedas;
- bases de datos;
- APIs;
- controles de seguridad;
- automatizaciones.
Para el usuario parece una sola experiencia.
Internamente puede existir una cadena de modelos y sistemas diferentes.
Esto explica por qué decir:
“Esta aplicación utiliza IA”
todavía deja muchas preguntas abiertas.
Una mejor pregunta es:
“¿Qué modelos o capacidades de IA utiliza y qué función desempeña cada uno?”
🧰 ¿Tenemos que Entrenar Nuestros Propios Modelos?
No necesariamente.
Y esta respuesta es fundamental para nuestro enfoque práctico.
Supongamos que queremos construir una aplicación que:
- resuma documentos;
- clasifique textos;
- transcriba audio;
- genere imágenes;
- reconozca objetos.
Antes de iniciar un entrenamiento desde cero deberíamos investigar:
¿Existe un modelo que ya realiza esta tarea?
Después podemos evaluar:
- calidad;
- costo;
- velocidad;
- privacidad;
- facilidad de integración;
- requisitos técnicos;
- posibilidad de personalización;
- restricciones de uso.
Entrenar desde cero puede requerir:
- datos;
- conocimientos especializados;
- infraestructura;
- capacidad computacional;
- tiempo;
- evaluación;
- mantenimiento.
Por eso, en IA aplicada, reutilizar un modelo existente puede ser una decisión técnica excelente, no una solución inferior.
Nuestro objetivo no es demostrar que sabemos complicar un problema.
Es resolverlo adecuadamente.
⚖️ Modelo Existente, Adaptado o Propio
Ante un problema podemos pensar inicialmente en tres posibilidades.
1. Utilizar un modelo existente
Tiene sentido cuando sus capacidades satisfacen suficientemente nuestras necesidades.
2. Adaptar un modelo existente
Puede resultar útil cuando necesitamos especializar determinadas capacidades sin comenzar completamente desde cero.
3. Entrenar un modelo específico
Puede ser necesario cuando:
- el problema es muy particular;
- disponemos de datos apropiados;
- los modelos existentes no satisfacen los requisitos;
- existe una justificación técnica y económica.
No existe una opción universalmente mejor.
La pregunta correcta es:
¿Qué alternativa resuelve mejor nuestro problema bajo nuestras restricciones?
🎛️ Parámetros No Es lo Mismo que Configuración
Aquí conviene introducir una distinción que encontraremos constantemente.
Parámetros
Son valores internos del modelo que se aprenden o ajustan durante el entrenamiento.
Configuración
Son decisiones que nosotros podemos establecer sobre cómo entrenamos o utilizamos un sistema.
En machine learning encontraremos posteriormente términos como hiperparámetros, que describen determinadas configuraciones del proceso.
Y al utilizar modelos generativos también encontraremos opciones que modifican la forma en que obtenemos resultados.
No necesitamos dominar todavía esas categorías.
Solo debemos evitar pensar que:
todo número que aparece en una herramienta es un parámetro aprendido del modelo.
📦 El Mismo Tipo de Modelo Puede Dar Lugar a Modelos Diferentes
Imaginemos dos equipos que utilizan una arquitectura similar.
El primero entrena con:
Datos A
El segundo con:
Datos B
Aunque partan de una estructura parecida, pueden obtener modelos con comportamientos diferentes.
También pueden cambiar:
- objetivos;
- configuraciones;
- duración del entrenamiento;
- preparación de los datos;
- criterios de evaluación.
Por eso debemos distinguir entre:
tipo o arquitectura de modelo
y
modelo entrenado concreto.
Más adelante esta distinción será especialmente importante cuando comparemos modelos disponibles para resolver tareas reales.
🧪 Actividad Práctica: Identifica Cada Pieza
Analiza este escenario.
Una fábrica quiere detectar productos defectuosos mediante fotografías.
Dispone de:
A. 50,000 imágenes históricas de productos.
B. Un procedimiento de aprendizaje que ajusta una red neuronal.
C. El archivo resultante después del entrenamiento con sus valores aprendidos.
D. Una cámara que fotografía productos nuevos.
E. Un resultado: “Posible defecto: 91 %”.
F. Una regla que envía el producto a inspección humana cuando el resultado supera determinado criterio.
Ahora identifica:
¿Cuáles son los datos de entrenamiento?
¿Cuál corresponde al proceso o algoritmo de aprendizaje?
¿Cuál es el modelo entrenado?
¿Cuál es la entrada durante la inferencia?
¿Cuál es la salida del modelo?
¿Cuál forma parte de la lógica posterior al modelo?
Intenta responder antes de continuar.
✅ Analicemos las Respuestas
A — Datos de entrenamiento
Las 50,000 imágenes proporcionan ejemplos utilizados durante el aprendizaje.
B — Proceso de entrenamiento
El procedimiento ajusta el modelo utilizando los datos.
C — Modelo entrenado
Contiene la estructura y los valores obtenidos como resultado del entrenamiento.
D — Entrada nueva
La fotografía del producto llega al modelo durante la utilización.
E — Salida
El modelo produce un resultado para esa entrada.
F — Lógica de la aplicación
La regla determina qué hacemos con el resultado.
Podemos representar todo:
Datos históricos → Entrenamiento → Modelo
Después:
Producto nuevo → Modelo → Resultado → Regla → Inspección humana
Si puedes separar estas piezas, ya estás pensando en un sistema de IA con mucha mayor precisión.
🔬 Experimento Conceptual: Quita el Modelo
Imagina nuevamente nuestra fábrica.
Tenemos:
- cámaras;
- software;
- base de datos;
- sistema de alertas;
- automatización;
- operadores.
Ahora eliminamos únicamente el modelo capaz de analizar las imágenes.
¿Qué queda?
La aplicación todavía puede:
- tomar fotografías;
- almacenarlas;
- mostrar información;
- registrar productos;
- enviar mensajes.
Pero ya no posee la capacidad aprendida para estimar si una imagen presenta el patrón asociado con un defecto.
Ahora haz el ejercicio contrario.
Conservamos únicamente el modelo.
Eliminamos:
- cámara;
- interfaz;
- integración;
- automatización;
- sistema de producción.
¿Tenemos una aplicación completa?
No.
Tenemos una capacidad computacional, pero todavía necesitamos integrarla dentro de una solución.
Esto demuestra:
Modelo + Software + Datos + Procesos + Personas = posible solución
El modelo puede ser una pieza extraordinariamente importante, pero no resuelve por sí solo todo el problema real.
🔎 Cómo Evaluar si un Modelo Puede Servirnos
Cuando encontremos un modelo que podríamos utilizar, no deberíamos preguntar únicamente:
“¿Es bueno?”
Necesitamos preguntas más concretas.
Por ejemplo:
- ¿Qué tarea realiza?
- ¿Qué tipo de entrada acepta?
- ¿Qué resultado produce?
- ¿Para qué contexto fue desarrollado?
- ¿Qué desempeño ha demostrado?
- ¿Qué tipos de errores puede cometer?
- ¿Qué recursos necesita?
- ¿Qué velocidad ofrece?
- ¿Dónde se ejecuta?
- ¿Qué ocurre con nuestros datos?
- ¿Qué restricciones de uso existen?
- ¿Puede integrarse con nuestra solución?
- ¿Necesita adaptación?
- ¿Cómo comprobaremos que funciona en nuestro caso?
Estas preguntas transforman:
“Quiero utilizar este modelo porque parece poderoso.”
en:
“Quiero comprobar si este modelo es adecuado para mi problema.”
Ése es el tipo de criterio que buscamos desarrollar.
🛠️ Mini Práctica: Diseña una Solución Alrededor de un Modelo
Elige un problema.
Por ejemplo:
clasificar solicitudes de clientes.
Ahora completa:
Problema:
¿Qué necesitamos resolver?
Entrada:
¿Qué recibirá el modelo?
Modelo:
¿Qué capacidad necesitamos?
Salida:
¿Qué debería producir?
Acción:
¿Qué hará la aplicación con el resultado?
Persona:
¿Existe alguna situación que requiera revisión humana?
Evaluación:
¿Cómo comprobaremos que el modelo funciona suficientemente bien?
Alternativa:
¿Necesitamos entrenarlo nosotros o podría existir ya un modelo utilizable?
Por ejemplo:
Problema: dirigir solicitudes al departamento correcto.
Entrada: mensaje del cliente.
Modelo: clasificación de texto.
Salida: categoría estimada.
Acción: enviar la solicitud al flujo correspondiente.
Persona: revisar casos dudosos.
Evaluación: comprobar clasificaciones correctas y tipos de error.
Alternativa: evaluar primero modelos existentes antes de entrenar uno propio.
Ya no estamos pensando únicamente en “usar IA”.
Estamos comenzando a diseñar una solución alrededor de una capacidad de IA.
📝 Comprueba lo que Aprendiste
- ¿Qué es un modelo de inteligencia artificial?
- ¿Cuál es la diferencia entre datos y modelo?
- ¿Cuál es la diferencia entre algoritmo de aprendizaje y modelo entrenado?
- ¿Qué son conceptualmente los parámetros?
- ¿Qué ocurre con los parámetros durante el entrenamiento?
- ¿Qué diferencia existe entre entrenamiento e inferencia?
- ¿Qué estructura representa
Entrada → Modelo → Salida? - ¿La salida del modelo tiene que convertirse automáticamente en una acción?
- ¿Por qué un modelo no es toda una aplicación?
- ¿Puede una aplicación utilizar varios modelos?
- ¿Necesitamos entrenar siempre nuestros propios modelos?
- ¿Qué ventajas puede tener utilizar un modelo previamente entrenado?
- ¿Qué diferencia existe entre parámetros aprendidos y configuraciones?
- ¿Dos modelos con una arquitectura similar pueden comportarse de manera diferente?
- ¿Qué deberíamos evaluar antes de seleccionar un modelo para un proyecto?
Si puedes explicar con claridad:
Datos → Entrenamiento → Modelo
y después:
Entrada nueva → Modelo → Inferencia → Resultado → Acción
ya tienes una representación conceptual muy útil de cómo se construyen muchas soluciones de machine learning.
📌 Ideas Clave de la Lección
- Un modelo de inteligencia artificial representa patrones o relaciones aprendidos para realizar una tarea.
- El modelo no es lo mismo que los datos utilizados para entrenarlo.
- El algoritmo o proceso de aprendizaje tampoco es lo mismo que el modelo resultante.
- Los parámetros son valores internos que pueden ajustarse durante el entrenamiento.
- Entrenar significa construir o ajustar el comportamiento del modelo utilizando datos y un proceso de aprendizaje.
- Inferencia significa utilizar un modelo entrenado con nuevas entradas.
- Un modelo puede producir clasificaciones, estimaciones, recomendaciones, contenido u otros resultados.
- La salida del modelo no tiene que convertirse automáticamente en una decisión.
- Un modelo es solamente una parte de una aplicación de IA.
- Una aplicación puede combinar varios modelos, reglas, software, automatizaciones y personas.
- No siempre necesitamos entrenar modelos desde cero.
- Podemos utilizar, adaptar o entrenar modelos según las necesidades del problema.
- El modelo más potente no es necesariamente el modelo más apropiado.
- Elegir un modelo requiere considerar el problema, desempeño, errores, recursos, integración, privacidad y otras restricciones reales.
🎯 Lo Que Ahora Eres Capaz de Hacer
Al comenzar este capítulo aprendiste a reconocer cuándo un problema podría beneficiarse de machine learning.
Después comprendiste cómo los datos, los patrones y el entrenamiento permiten que ocurra el aprendizaje.
Ahora puedes identificar qué queda después del entrenamiento y cómo se utiliza.
Puedes separar:
Datos
Proceso de entrenamiento
Modelo
Entrada nueva
Inferencia
Resultado
Acción
Y puedes hacer una pregunta todavía más importante:
¿Necesitamos construir un modelo o podemos utilizar uno que ya existe?
Esta última pregunta será fundamental para nuestro enfoque de Inteligencia Artificial Aplicada.
Nuestro objetivo no será construir todo desde cero por principio.
Será aprender a seleccionar, utilizar, integrar, adaptar y, cuando realmente sea necesario, entrenar las herramientas apropiadas para resolver problemas reales.
🧭 Continúa Tu Ruta de Aprendizaje
Ya tenemos una base para comprender qué es machine learning, cómo ocurre el aprendizaje y qué es un modelo de inteligencia artificial.
A partir de aquí podremos diferenciar distintas maneras en que los modelos pueden aprender de los datos y comprender qué tipo de enfoque resulta apropiado para diferentes problemas.