Lección 8 — Qué Es Machine Learning y Para Qué Sirve
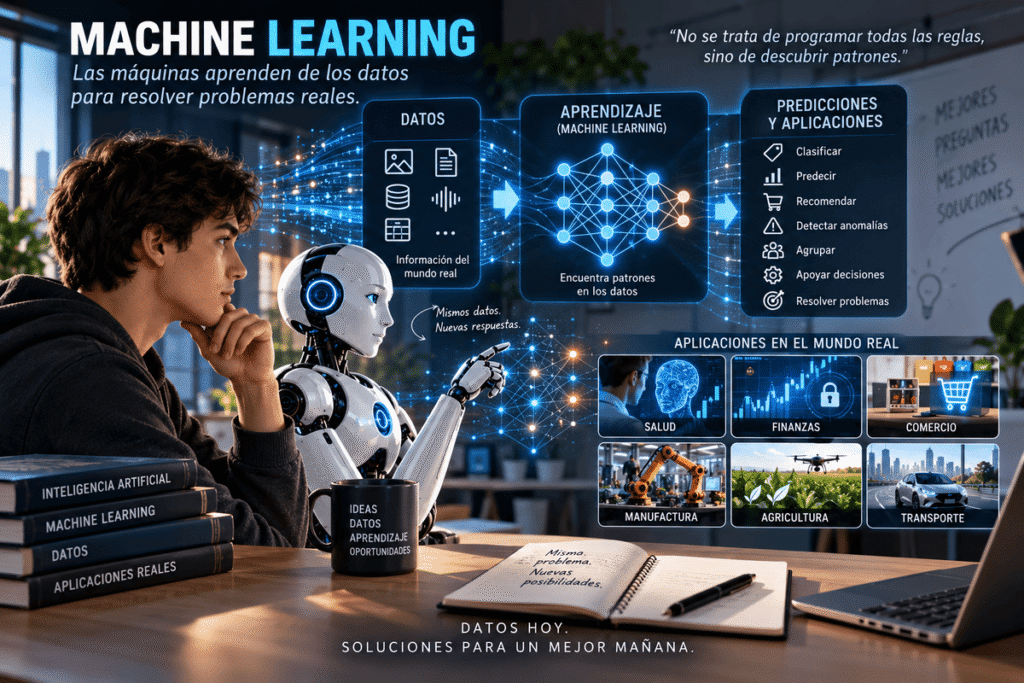
Para comprender qué es machine learning, podemos empezar con una idea sencilla: en lugar de programar explícitamente todas las reglas necesarias para resolver determinadas tareas, utilizamos datos y algoritmos para construir modelos capaces de aprender patrones y utilizarlos ante nuevos casos.
El machine learning, también llamado aprendizaje automático, es una de las áreas más importantes de la inteligencia artificial moderna. Se utiliza cuando queremos resolver problemas en los que escribir manualmente todas las reglas sería difícil, poco práctico o insuficiente, pero disponemos de datos a partir de los cuales podemos encontrar patrones útiles.
Esto no significa que una máquina aprenda exactamente como una persona ni que pueda resolver automáticamente cualquier problema. Significa que podemos construir sistemas cuyo comportamiento para determinadas tareas se obtiene, al menos en parte, aprendiendo patrones a partir de datos.
🎯 Qué Aprenderás en Esta Lección
Al finalizar esta lección podrás:
- explicar qué es machine learning o aprendizaje automático;
- comprender para qué sirve;
- reconocer la diferencia fundamental entre programar reglas y aprender patrones;
- identificar problemas en los que machine learning puede resultar útil;
- reconocer ejemplos de clasificación, predicción y recomendación;
- comprender por qué los datos son fundamentales;
- distinguir entre entrenamiento y utilización de un modelo a nivel conceptual;
- reconocer situaciones donde machine learning no es necesario;
- analizar un problema antes de decidir si conviene utilizar aprendizaje automático.
La capacidad práctica que buscamos desarrollar es:
observar un problema y determinar si existen patrones que podrían aprenderse a partir de datos o si sería más apropiado resolverlo mediante reglas explícitas.
🧠 ¿Qué Es Machine Learning?
Machine learning es un enfoque de inteligencia artificial que permite construir modelos capaces de aprender patrones a partir de datos para realizar determinadas tareas sin especificar manualmente todas las reglas necesarias para cada caso.
La expresión en español es:
aprendizaje automático.
Ambos términos se utilizan ampliamente, aunque machine learning es especialmente frecuente en documentación, herramientas y entornos profesionales.
La idea fundamental puede resumirse así:
Datos → Aprendizaje de patrones → Modelo
Una vez obtenido el modelo:
Nuevo dato → Modelo → Resultado
El resultado puede ser, dependiendo del problema:
- una categoría;
- una predicción;
- una estimación;
- una recomendación;
- una puntuación;
- la identificación de un patrón.
Más adelante aprenderemos cómo se entrenan estos modelos. Por ahora nos interesa comprender qué cambia cuando utilizamos machine learning para resolver un problema.
💻 Programación Tradicional vs. Machine Learning
En la Lección 4 estudiamos que la programación tradicional permite especificar instrucciones y reglas que una computadora ejecuta.
Imaginemos que necesitamos calcular el descuento de un cliente:
Si compra más de $1,000 → descuento del 10 %
Si compra $1,000 o menos → sin descuento
La regla es clara.
Podemos programarla directamente.
De manera simplificada:
Datos + Reglas programadas → Resultado
Pero pensemos ahora en otro problema:
¿Este mensaje de correo electrónico es spam?
Podríamos intentar escribir reglas:
- si contiene determinada palabra → spam;
- si tiene muchos enlaces → spam;
- si utiliza determinada frase → spam.
El problema es que los mensajes pueden variar enormemente.
Los remitentes también pueden modificar su comportamiento para evitar las reglas conocidas.
En determinadas situaciones puede resultar más útil disponer de muchos ejemplos anteriores y construir un modelo que aprenda patrones relacionados con ambas categorías:
Ejemplos de mensajes → Aprendizaje → Modelo
Después:
Nuevo mensaje → Modelo → Spam / No spam
Ésta es una de las diferencias fundamentales que debemos comprender.
Programación tradicional: nosotros especificamos las reglas.
Machine learning: utilizamos datos para aprender patrones que el modelo podrá aplicar a nuevos casos.
⚠️ Esto No Significa que Machine Learning Elimine la Programación
Sería un error interpretar lo anterior como:
“Machine learning sustituye a la programación.”
No es así.
Un sistema de aprendizaje automático necesita software para:
- obtener datos;
- almacenarlos;
- procesarlos;
- entrenar o utilizar modelos;
- presentar resultados;
- conectarse con otros sistemas;
- aplicar reglas;
- ejecutar acciones;
- registrar lo ocurrido.
Por ejemplo, una tienda podría utilizar un modelo para estimar qué productos podrían interesar a un cliente.
Pero todavía necesita programación para:
- mostrar los productos;
- administrar el carrito;
- calcular precios;
- procesar pedidos;
- gestionar inventario;
- registrar pagos;
- enviar confirmaciones.
Por tanto:
Machine learning no reemplaza necesariamente la programación tradicional; normalmente se integra con ella.
🎯 ¿Para Qué Sirve Machine Learning?
El aprendizaje automático resulta especialmente útil cuando queremos encontrar y utilizar patrones en datos para resolver tareas donde las reglas explícitas pueden ser difíciles de construir o mantener.
Algunos usos frecuentes incluyen:
- clasificar información;
- realizar predicciones;
- estimar valores;
- detectar patrones inusuales;
- recomendar elementos;
- reconocer contenido;
- ordenar resultados;
- apoyar decisiones.
Lo importante no es memorizar esta lista.
Debemos aprender a identificar qué tipo de resultado necesitamos obtener.
Veamos algunos ejemplos.
📧 Ejemplo 1: Clasificar Mensajes
Supongamos que una empresa recibe miles de mensajes.
Necesita clasificarlos como:
- ventas;
- soporte;
- facturación;
- reclamaciones;
- otros.
Una solución basada exclusivamente en palabras clave podría funcionar parcialmente.
Pero aparecen mensajes como:
“Me cobraron dos veces el último pedido.”
No contiene necesariamente la palabra “facturación”, pero una persona puede reconocer fácilmente de qué trata.
Si disponemos de suficientes ejemplos previamente clasificados, podríamos utilizar machine learning para aprender patrones relacionados con cada categoría.
Entonces:
Mensajes anteriores + categorías → Aprendizaje → Modelo
y posteriormente:
Nuevo mensaje → Modelo → Categoría estimada
Después, una automatización podría enviar el mensaje al departamento correspondiente.
Observa que nuevamente combinamos:
Machine learning + Programación + Automatización
🏠 Ejemplo 2: Estimar el Valor de una Vivienda
Supongamos que queremos estimar el precio de una vivienda utilizando características como:
- superficie;
- ubicación;
- número de habitaciones;
- antigüedad;
- características del inmueble.
Podríamos intentar escribir manualmente una enorme colección de reglas.
Pero las relaciones entre estas variables y el precio pueden ser complejas.
Si disponemos de datos históricos de viviendas y sus precios, un algoritmo puede utilizarlos para aprender relaciones útiles.
Después podríamos introducir las características de una vivienda nueva y obtener:
Precio estimado: $X
Aquí el modelo no está asignando simplemente una categoría.
Está intentando estimar un valor numérico.
Más adelante aprenderemos que este tipo de problema puede abordarse mediante técnicas de regresión.
Por ahora basta con reconocer la tarea:
utilizar patrones históricos para estimar un valor desconocido.
🎬 Ejemplo 3: Recomendaciones
Imagina una plataforma con miles de películas.
El problema no consiste únicamente en almacenar el catálogo.
Necesitamos responder:
¿Qué películas podrían resultar relevantes para este usuario?
Dependiendo del sistema, podrían utilizarse señales como:
- contenidos vistos;
- interacciones anteriores;
- valoraciones;
- características de las películas;
- patrones de otros usuarios.
Un modelo puede utilizar esos datos para estimar qué elementos podrían ser relevantes.
Después:
Datos disponibles → Modelo → Recomendaciones
La aplicación muestra esas recomendaciones.
El usuario decide qué quiere ver.
Machine learning ayuda a estimar relevancia, pero no toma necesariamente la decisión final.
💳 Ejemplo 4: Detectar Patrones Inusuales
Pensemos nuevamente en operaciones financieras.
Una institución puede procesar enormes cantidades de transacciones.
Machine learning puede utilizarse para identificar operaciones cuyos patrones difieren de lo esperado.
El resultado podría ser:
Operación → Modelo → Puntuación de riesgo
Si la puntuación supera determinado criterio, el sistema podría solicitar una revisión adicional.
Pero debemos recordar lo aprendido en la lección anterior:
“inusual” no significa automáticamente “fraudulento”.
El modelo proporciona información que después debe incorporarse correctamente al proceso.
👁️ Ejemplo 5: Reconocer Contenido en Imágenes
Supongamos que queremos distinguir fotografías de dos tipos de objetos.
Con programación tradicional podríamos intentar definir reglas relacionadas con:
- colores;
- formas;
- tamaños;
- bordes.
Pero los objetos pueden aparecer:
- desde diferentes ángulos;
- con distinta iluminación;
- parcialmente ocultos;
- sobre diferentes fondos;
- con múltiples tamaños.
Escribir manualmente todas las combinaciones posibles puede resultar extremadamente difícil.
Con machine learning podemos utilizar ejemplos para construir un modelo capaz de aprender patrones relevantes.
Después:
Nueva imagen → Modelo → Categoría estimada
Este principio se encuentra detrás de muchas aplicaciones modernas de visión por computadora.
🔍 ¿Qué Tienen en Común Estos Problemas?
Los ejemplos anteriores parecen muy diferentes.
Tenemos:
- correo electrónico;
- viviendas;
- películas;
- transacciones;
- imágenes.
Sin embargo, comparten una idea:
existen datos anteriores o ejemplos a partir de los cuales podemos intentar aprender patrones útiles para nuevos casos.
Ésta es una señal importante para detectar posibles problemas de machine learning.
Podemos empezar preguntando:
¿Tenemos ejemplos o datos relacionados con el problema?
Después:
¿Existe algún patrón que pueda ayudarnos a producir el resultado que necesitamos?
Y finalmente:
¿Podemos evaluar si ese resultado es suficientemente útil?
Estas tres preguntas son mucho más importantes que comenzar preguntando:
“¿Qué algoritmo de machine learning utilizamos?”
📊 Los Datos Son Parte Fundamental del Problema
Machine learning depende profundamente de los datos.
Podemos tener un algoritmo sofisticado, pero si nuestros datos son:
- insuficientes;
- incorrectos;
- incompletos;
- poco representativos;
- mal etiquetados;
- desactualizados;
el modelo puede aprender patrones poco útiles.
Imagina que queremos construir un sistema para reconocer diferentes frutas.
Disponemos de 10,000 fotografías.
Parece una cantidad excelente.
Pero descubrimos que:
- 9,800 son manzanas;
- 100 son naranjas;
- 100 son peras.
El número total por sí solo no nos dice si los datos son adecuados.
También debemos comprender:
- qué contienen;
- cómo fueron obtenidos;
- qué casos representan;
- qué casos faltan;
- qué errores existen.
Más adelante estudiaremos estos problemas con mayor profundidad.
Por ahora conserva esta idea:
la calidad de una solución de machine learning depende también de la calidad y pertinencia de los datos utilizados.
🏋️ Entrenar No Es lo Mismo que Utilizar
Esta distinción ya apareció cuando estudiamos cómo funciona la inteligencia artificial y ahora adquiere especial importancia.
Durante el entrenamiento, utilizamos datos y un algoritmo de aprendizaje para construir o ajustar un modelo.
Simplificando:
Datos → Entrenamiento → Modelo
Después podemos utilizar el modelo con información nueva:
Nuevo dato → Modelo → Resultado
A esta segunda etapa se le suele llamar inferencia.
Por ejemplo:
Entrenamiento
Utilizamos miles de imágenes previamente disponibles para construir un modelo.
Inferencia
Le mostramos una imagen nueva y el modelo produce una clasificación.
Son procesos relacionados, pero no son lo mismo.
Y utilizar un modelo tampoco significa necesariamente que éste esté aprendiendo continuamente de cada nueva interacción.
🧩 Machine Learning Es un Medio, No el Objetivo
Supongamos que una empresa nos dice:
“Queremos implementar machine learning.”
Nuestra primera pregunta no debería ser:
“¿Qué modelo quieren utilizar?”
Debería ser:
“¿Qué problema quieren resolver?”
Tal vez el verdadero problema sea:
- reducir devoluciones;
- clasificar solicitudes;
- detectar defectos;
- estimar demanda;
- recomendar productos;
- identificar anomalías.
Una vez comprendido el problema podemos analizar si machine learning aporta alguna ventaja.
Ésta es exactamente nuestra filosofía:
El Problema Primero. La Tecnología Después.
💻 Primero define el problema; después, los recursos
Para comenzar a experimentar con machine learning no necesitas comprar el equipo más potente. Muchos ejercicios pueden realizarse con herramientas en línea o con recursos informáticos relativamente modestos.
Cuando tus proyectos requieran trabajar localmente con mayores conjuntos de datos o modelos más exigentes, podrás evaluar qué capacidad de procesamiento, memoria y almacenamiento necesitas realmente.
Explora opciones para tus proyectos tecnológicos →
🚫 No Todos los Problemas Necesitan Machine Learning
Ésta es probablemente una de las ideas más útiles de toda la lección.
Si un problema puede resolverse mediante una regla clara, estable y sencilla, utilizar machine learning puede añadir complejidad innecesaria.
Imagina:
Si la temperatura supera 30 °C → encender ventilador.
No necesitamos entrenar un modelo con miles de ejemplos para descubrir esa regla.
Podemos programarla directamente.
Otro ejemplo:
IVA = precio × tasa correspondiente
Si conocemos la regla exacta, tampoco necesitamos que un modelo “aprenda” a calcularla.
Por eso debemos comparar siempre:
¿Podemos expresar la solución mediante reglas claras?
frente a:
¿Necesitamos aprender patrones complejos a partir de datos?
Machine learning tiene sentido cuando aporta una ventaja real, no simplemente porque podamos utilizarlo.
⚖️ Reglas o Machine Learning: ¿Cómo Decidir?
No existe una fórmula universal, pero podemos comenzar con algunos criterios.
Las reglas pueden ser apropiadas cuando:
- conocemos claramente la lógica;
- las condiciones son relativamente estables;
- necesitamos resultados completamente deterministas;
- existen pocas excepciones;
- la solución es fácil de mantener.
Machine learning puede ser apropiado cuando:
- existen patrones difíciles de expresar mediante reglas;
- disponemos de datos relevantes;
- necesitamos realizar predicciones o estimaciones;
- existen muchas combinaciones posibles;
- el comportamiento puede aprenderse mejor mediante ejemplos;
- podemos evaluar objetivamente el desempeño obtenido.
Y también puede existir una tercera posibilidad:
combinar ambos enfoques.
En aplicaciones reales esto ocurre constantemente.
🤝 Reglas + Machine Learning + Automatización
Imagina un sistema para procesar solicitudes de clientes.
Paso 1 — Machine learning
Un modelo clasifica el mensaje:
Facturación
Paso 2 — Regla
Si la categoría es “Facturación” y la confianza supera determinado criterio:
enviar al flujo correspondiente.
Paso 3 — Automatización
El sistema:
- registra la solicitud;
- asigna un número;
- la envía al departamento;
- notifica al cliente.
Paso 4 — Persona
Un especialista revisa y resuelve el caso.
Tenemos:
IA → Regla → Automatización → Persona
No necesitamos escoger siempre entre “todo IA” o “nada IA”.
Una buena solución utiliza cada tecnología donde aporta valor.
⚠️ Aprender Patrones No Significa Comprender Como una Persona
Cuando decimos que un modelo “aprende”, utilizamos un término técnico que puede resultar engañoso si lo interpretamos exactamente como aprendizaje humano.
Un modelo puede aprender relaciones estadísticas extremadamente útiles sin poseer:
- experiencias humanas;
- comprensión consciente;
- sentido común general;
- intenciones;
- conocimiento completo del mundo.
Por ejemplo, un modelo puede aprender a distinguir determinadas imágenes con gran precisión.
Eso no significa necesariamente que comprenda esos objetos de la misma manera que una persona.
Por eso debemos evitar convertir palabras técnicas como:
aprender, entender, reconocer o decidir
en afirmaciones exageradas sobre lo que ocurre dentro del sistema.
📉 Un Modelo Puede Equivocarse
Supongamos que entrenamos un modelo para clasificar solicitudes de clientes.
Recibe 1,000 mensajes nuevos.
Clasifica correctamente 920.
Se equivoca en 80.
¿Es bueno?
La respuesta correcta es:
depende.
Necesitamos saber:
- qué tipo de errores cometió;
- qué consecuencias tienen;
- qué desempeño necesitamos;
- cómo se compara con otras alternativas;
- cuánto cuesta corregir los errores;
- si algunos errores son mucho más importantes que otros.
Un 92 % puede ser excelente para una aplicación y completamente insuficiente para otra.
La evaluación de un modelo no puede separarse del problema real que intentamos resolver.
🧪 Actividad Práctica: ¿Reglas o Machine Learning?
Analiza las siguientes situaciones.
Caso A
Una tienda ofrece envío gratuito cuando una compra supera $1,500.
¿Necesitamos machine learning?
Caso B
Queremos identificar automáticamente fotografías que contienen perros.
¿Podrían resultar útiles ejemplos y aprendizaje de patrones?
Caso C
Una empresa quiere estimar cuántos productos podría vender el próximo mes utilizando datos históricos y otras variables.
¿Existe un posible problema de predicción?
Caso D
Un sistema debe impedir que una persona menor de 18 años acceda a determinado servicio cuando conocemos exactamente su edad.
¿Necesitamos que un modelo aprenda la regla?
Caso E
Una fábrica quiere detectar defectos visuales que presentan muchas formas y variaciones.
¿Podría ser útil machine learning?
Intenta responder antes de continuar.
✅ Analicemos las Respuestas
Caso A — Reglas
La condición es explícita:
Compra > $1,500 → envío gratuito
No necesitamos aprenderla.
Caso B — Machine learning puede ser útil
Las imágenes presentan enorme variabilidad y resulta difícil describir manualmente todas las reglas necesarias.
Caso C — Machine learning puede ser una opción
Si existen datos adecuados, podríamos intentar aprender relaciones que permitan estimar la demanda.
Pero primero debemos definir exactamente qué queremos predecir y cómo evaluaremos el resultado.
Caso D — Regla
Si conocemos la edad y la condición legal o empresarial aplicable es explícita, podemos implementar la regla directamente.
Caso E — Machine learning puede ser útil
La visión por computadora puede ayudar cuando los defectos presentan patrones visuales difíciles de representar mediante reglas simples.
Observa que no preguntamos primero:
“¿Qué algoritmo utilizamos?”
Primero analizamos la naturaleza del problema.
🔬 Experimento Conceptual: Intenta Escribir las Reglas
Éste es un ejercicio sencillo que puedes aplicar a muchos problemas.
Supongamos que queremos construir un sistema capaz de identificar si una fotografía contiene un gato.
Antes de pensar en machine learning, intenta escribir todas las reglas.
Tal vez comiences:
- tiene cuatro patas;
- tiene dos orejas;
- tiene cola;
- tiene pelo.
Pero inmediatamente aparecen problemas.
Un perro también puede cumplir esas condiciones.
Además:
- el gato puede estar acostado;
- quizá no veamos sus patas;
- puede estar parcialmente oculto;
- la fotografía puede ser oscura;
- puede aparecer solamente su cara;
- puede existir más de un animal;
- puede ser una ilustración.
¿Cuántas reglas necesitaríamos?
Ahora imagina disponer de muchos ejemplos de imágenes correctamente identificadas.
Aquí empieza a resultar evidente por qué aprender patrones a partir de ejemplos puede ser útil.
Este ejercicio no demuestra automáticamente que machine learning sea siempre la solución correcta.
Nos ayuda a reconocer cuándo escribir manualmente las reglas comienza a resultar impráctico.
🔎 Cómo Detectar un Posible Problema de Machine Learning
Cuando analices una situación real, utiliza estas preguntas:
- ¿Qué problema queremos resolver?
- ¿Qué resultado necesitamos producir?
- ¿Podemos escribir reglas claras para obtenerlo?
- ¿Existen demasiadas variaciones o excepciones?
- ¿Disponemos de datos relacionados con el problema?
- ¿Los datos representan razonablemente los casos que encontraremos?
- ¿Existe algún patrón que podamos aprender?
- ¿Cómo mediremos si el resultado es suficientemente bueno?
- ¿Qué ocurre cuando el modelo se equivoca?
- ¿Una solución más sencilla resolvería suficientemente bien el problema?
Si no puedes responder todavía qué problema quieres resolver, aún es demasiado pronto para elegir un modelo.
🛠️ Mini Práctica: Encuentra un Problema en Tu Entorno
Observa alguna actividad de tu vida cotidiana, profesión, negocio o área de estudio.
Busca una tarea que implique:
- clasificar;
- estimar;
- predecir;
- recomendar;
- reconocer;
- detectar patrones.
Por ejemplo:
Problema: identificar mensajes urgentes entre cientos de solicitudes.
Ahora completa:
Resultado deseado:
¿Qué queremos que produzca el sistema?
Datos disponibles:
¿Qué información tenemos?
Reglas posibles:
¿Podemos resolverlo fácilmente mediante reglas?
Patrones:
¿Existen ejemplos anteriores de los que podríamos aprender?
Errores:
¿Qué ocurriría si el sistema se equivoca?
Evaluación:
¿Cómo sabríamos si la solución funciona suficientemente bien?
No necesitas construir todavía ningún modelo.
El objetivo es aprender algo anterior y más importante:
reconocer cuándo un problema podría ser candidato para machine learning.
📝 Comprueba lo que Aprendiste
- ¿Qué es machine learning?
- ¿Qué significa aprendizaje automático?
- ¿Cuál es la diferencia fundamental entre programar reglas y aprender patrones?
- ¿Por qué machine learning no elimina la necesidad de programación?
- ¿Para qué tipo de tareas puede utilizarse?
- ¿Por qué los datos son fundamentales?
- ¿Qué diferencia existe entre entrenamiento e inferencia?
- ¿Utilizar un modelo significa necesariamente que aprende de cada interacción?
- ¿Por qué una regla sencilla puede ser preferible a machine learning?
- ¿Puede una solución combinar reglas, automatización y machine learning?
- ¿Por qué “aprender” no debe interpretarse exactamente como aprendizaje humano?
- ¿Un porcentaje de aciertos alto garantiza que un modelo sea adecuado?
- ¿Qué debemos definir antes de elegir un algoritmo?
- ¿Qué pregunta deberíamos hacernos antes de decidir utilizar machine learning?
Si tu respuesta a la última comienza con:
“¿Qué problema queremos resolver?”
estamos construyendo el criterio correcto.
📌 Ideas Clave de la Lección
- Machine learning significa aprendizaje automático.
- Permite construir modelos que aprenden patrones a partir de datos.
- No necesitamos programar explícitamente todas las reglas que determinan el comportamiento de determinadas tareas.
- Machine learning puede utilizarse para clasificación, predicción, estimación, recomendación, reconocimiento y detección de patrones.
- Los datos son fundamentales, pero cantidad no significa automáticamente calidad.
- Entrenar un modelo y utilizarlo son procesos diferentes.
- Machine learning no sustituye necesariamente a la programación tradicional.
- Reglas, automatización, software convencional y modelos pueden trabajar juntos.
- No todos los problemas necesitan machine learning.
- Una regla clara puede ser mejor que un modelo innecesariamente complejo.
- Un modelo puede equivocarse y sus errores deben evaluarse según el contexto.
- La elección de la tecnología comienza comprendiendo el problema.
🎯 Lo Que Ahora Eres Capaz de Hacer
Antes de esta lección podías reconocer que muchas aplicaciones utilizan inteligencia artificial.
Ahora puedes dar un paso adicional.
Ante un problema puedes comenzar a distinguir entre:
“Conozco las reglas y puedo programarlas.”
y:
“Las reglas son difíciles de especificar, pero quizá existan patrones que podamos aprender a partir de datos.”
Ésa es una de las decisiones fundamentales al diseñar soluciones con inteligencia artificial.
Todavía no necesitamos conocer todos los algoritmos ni las matemáticas internas.
Primero necesitamos saber cuándo tiene sentido utilizarlos.
🧭 Continúa Tu Ruta de Aprendizaje
Ya sabemos qué es machine learning, para qué sirve y qué características pueden convertir un problema en candidato para aprendizaje automático.
El siguiente paso será mirar dentro del proceso que hasta ahora hemos resumido como:
Datos → Aprendizaje → Modelo
y comprender qué significa realmente que un sistema aprenda patrones a partir de ejemplos.